연구개발비 집행 데이터 기반 이상징후 탐지 모델 연구
 ; 황경호**
; Gyung-Ho Hwang**
초록
국가 연구개발비 집행의 투명성 확보를 위해 도메인 규칙 기반 탐지와 비지도 머신러닝(Isolation Forest, LOF)을 결합한 혼합 이상탐지 모델을 제안한다. 특정거래처집중거래·연말집중집행·반복고정금액·비정상고액월간집행의 4가지 규칙 기반 패턴과 IF·LOF 이상 점수를 가중합산(40:30:30)하여 기관별 종합위험지수를 산출하고, 상위 10%를 주의기관으로 분류한다. 한국연구재단 이지바로 시스템의 2023~2025년 실 데이터(1,973,622건, 7,589개 기관)에 적용한 결과 종합위험지수 순위에 따라 전체 기관의 상위 10%인 759개 기관을 주의기관으로 분류하였으며, 탐지 방법별로 서로 다른 기관 집합이 식별되는 경향을 확인하였다. 다만 현행 가중치 구조상 규칙기반 패턴이 전혀 없는 기관은 주의기관 컷오프에 도달할 수 없어, 머신러닝은 규칙 탐지 기관 내 우선순위 재정렬에 주로 기여함을 확인하였다.
Abstract
This paper proposes a combined anomaly detection model that integrates domain rule-based detection with unsupervised machine learning (Isolation Forest, LOF) to audit government R&D fund expenditure. Four rule-based patterns and IF/LOF anomaly scores are weighted (40:30:30) into an institution-level composite risk index, from which the top 10% are classified as watchlist institutions. Applying the model to real data (1,973,622 records, 7,589 institutions, 2023-2025) from the National Research Foundation of Korea (NRF) Ezbaro system, the top 10% criterion selected 759 watchlist institutions, and the methods tended to flag different sets of institutions. Under the current weighting structure, institutions with no rule-based pattern cannot reach the watchlist cutoff, indicating ML mainly re-prioritizes institutions already flagged by rules.
Keywords:
anomaly detection, isolation forest, local outlier factor, machine learning, R&D fund expenditureⅠ. 서 론
국가 연구개발사업 규모가 확대되면서 연구비 집행의 투명성 확보가 중요한 과제로 부각되고 있으나, 수작업 중심 점검만으로는 방대한 거래 데이터에서 이상 패턴을 효과적으로 식별하기 어렵다. 정부R&D 예산은 2023년 31조 원대에서 2024년 26.5조 원으로 감소했다가 2025년 29.6조 원으로 다시 증가하는 등 변동 폭이 컸으며, 연구비 부정집행은 특정 거래처와의 반복 거래, 연말 집중 지출, 수의계약 한도 근접 분할 집행 등 다양한 형태로 나타난다. 여기에 「연구개발비 사용 기준」이 2026년에만 세 차례 개정되는 등 관련 규정 개정이 잦아지면서, 규칙 기반 점검만으로 최신 기준을 일관되게 반영하기가 더욱 어려워지고 있다.
또한 한국연구재단은 부정수급 방지를 위해 연구비집행통합모니터링시스템(RUCAS)을 운영하고 있으나, 사전 정의된 규칙에 기반하므로 신규 유형의 부정집행 패턴이나 복합적 이상 패턴을 탐지하는 데는 한계가 있다. 특히 한국연구재단 이지바로 시스템은 카드 결제와 일반 결제라는 서로 다른 방식의 거래 데이터를 보유하여, 이를 함께 고려한 탐지 방법이 필요하다.
본 논문에서는 규칙 기반 탐지와 비지도 머신러닝을 결합한 혼합 이상탐지 모델을 제안하고 실 데이터에 적용하여 적용 가능성을 탐색한다.
Ⅱ. 관련 연구
IF(Isolation Forest)[1]와 LOF(Local Outlier Factor)[2]와 같은 비지도 머신러닝 기법은 레이블 없이 다변량 이상치를 탐지할 수 있어 미지의 패턴 발견에 유리하지만, 결과의 해석과 실무 적용이 상대적으로 어렵다[3]. 이러한 비지도 이상탐지 기법들의 개념과 활용은 여러 문헌에서 체계적으로 정리되었다[4].
국내에서도 이상치 유형과 데이터 속성에 따른 탐지 알고리즘 성능을 비교한 연구[5][6]가 수행되었으며, 다양한 데이터셋을 대상으로 대표적인 비지도 알고리즘들의 성능을 폭넓게 비교·평가한 연구[7]도 보고되었다. 한편 센서·금융 등 특정 도메인에 특화하여 비지도 학습 기반 탐지 성능을 검증하거나 딥러닝 기반 접근을 정리한 연구[8][9]도 이루어졌다.
다변량 시계열 이상 탐지 과업에서 IF, LOF, 오토인코더 등 주요 비지도 학습 모델의 성능을 비교한 연구[10]에서는 데이터 특성에 따라 적합한 알고리즘이 달라짐이 보고되었다. 또한 인공신경망 기반의 부적정 연구비 탐지모형에 관한 연구[11]와 군집분석과 Isolation Forest를 결합한 이상 항적 탐지 연구[12]도 수행되었으나, 규칙 기반과 비지도 학습을 결합한 혼합 구조에 대한 검토는 미흡하였다.
Ⅲ. 제안 방법
3.1 규칙 기반 탐지
도메인 지식에 기반하여 다음 4가지 이상징후 패턴을 정의하였다.
① 특정 거래처 집중거래는 특정 거래처에 대한 연간 집행액이 해당 기관의 연간 총 집행액에서 차지하는 비중이 70% 이상이면서, 그 거래처에 대한 연간 집행액 자체도 1천만 원 이상인 경우로 정의하였다(소액 거래 1~2건만으로 비중이 우연히 높게 산출되는 것을 배제하기 위해 두 조건을 함께 적용). ② 연말집중집행은 11~12월 두 달간의 집행액 합이 연간 총 집행액의 40% 이상이거나, 월별 집행액의 변동 폭(월별 집행액의 표준편차를 평균으로 나눈 값)이 전체 기관 중 상위 10% 안에 들 만큼 유난히 들쭉날쭉한 경우로 정의하였다. ③ 반복고정금액은 동일 기관-거래처 조합에서 3개월 이상 계속해서, 월별 집행액의 변동 폭이 0.05 이하로 거의 일정하고 평균 집행액이 100만 원 이상인 경우로 정의하였다. ④ 비정상고액월간집행은 해당 월의 집행액이 그 기관의 평균 집행액보다 표준편차의 3배 이상 크게 벗어난 경우로 정의하였다. 다만 ④는 자기참조적 구조로 인해 표본표준편차(n-1) 기준 Z-score 3σ 도달에 이론상 최소 11개월의 거래 이력이 필요하다는 제약이 있다.
특성 변수는 이지바로 Oracle DB에서 CTE(Common Table Expression) 기반 SQL(Structured Query Language)로 추출하였으며, 카드 결제 데이터는 7단계, 일반 결제 데이터는 5단계 CTE 구조를 통해 각각 11개, 12개 변수로 가공하였다. 결측·오류 레코드 제거 후, 소수의 초고액 거래가 모델에 과도한 영향을 미치지 않도록 log1p 변환을 적용하고, 이어서 StandardScaler로 정규화하였다.
3.2 머신러닝 탐지
카드·일반 결제 데이터로부터 도출한 특성 변수에 IF와 LOF를 각각 적용하여 레코드 단위의 다변량 이상 점수를 산출하였다. 입력 변수는 합산집행액, 합산건수, 카드집행액, 일반결의집행액, 카드비율, 수단혼용, 카드최대건수, 카드연속건수, 임계근접발생일수(수의계약 한도액인 300만 원에 근접한 반복 집행 발생 일수), 월숫자 등 10개 변수로 구성하였다.
모든 특성 변수는 StandardScaler로 표준화(평균 0, 표준편차 1)한 후 사용하였다. IF는 전체 데이터(1,973,622건)에 이상치 비율을 1%로 가정(contamination=0.01)하여 scikit-learn[13]으로 구현·적용하였으며, 다른 데이터와 쉽게 분리되는 레코드일수록 높은 이상 점수를 받도록 하였다. LOF는 n_neighbors=20, contamination=0.01로 설정하고, 계산량 절감을 위해 100,000건을 무작위 추출해 모델을 학습한 뒤 나머지 데이터에 순차 적용하였다(학습에 쓰인 100,000건은 별도 방식으로 재산출해 왜곡 방지).
각 알고리즘의 레코드별 점수는 기관 단위로 합산해야 하므로, IF는 기관에 속한 레코드 중 가장 이상치에 가까운 값을, LOF는 저활동 기관에서 점수가 비정상적으로 튀는 문제를 피하기 위해 기관 내 상위 5% 수준에 해당하는 값을 대표 점수로 사용하였다.
3.3 종합 위험 지수
규칙 기반 패턴 발현, IF 점수, LOF 점수를 표 1과 같이 40:30:30으로 가중 합산하여 기관별 종합 위험 지수(0~100점)를 산출하고, 상위 10%에 해당하는 기관을 주의기관으로 분류한다. 규칙 기반 지표는 현행 규정과 직접 연계되어 해석 가능성이 높으므로 상대적으로 높은 가중치(40%)를 부여하였고, IF와 LOF는 상이한 탐지 메커니즘을 사용하며 어느 한쪽을 우선할 이론적 근거가 없어 동일 가중치(각 30%)를 적용하였다. IF·LOF 점수는 백분위 순위를 0~100점으로 환산하여 알고리즘 간 원점수 척도 차이를 보정하였다. 규칙 기반 패턴발현 점수는 발현된 유형 수에 25점을 곱해 산출하며(최대 100점), 상위 10% 컷오프는 전체 기관의 종합위험지수 분포에서 90번째 백분위수에 해당하는 점수(68.70점) 이상인 기관을 모두 포함하는 방식으로 결정하였다.

Composite risk index criteria and weights
Ⅳ. 실험 및 결과
4.1 데이터
2023~2025년 한국연구재단 이지바로 시스템의 카드 결제 및 일반 결제 데이터를 추출·가공하여, 기관-거래처-월 단위로 집계된 1,973,622건, 7,589개 기관을 분석 대상으로 하였다. 연도별 기관 수 및 거래 건수 추이는 그림 1과 같다. 연도별로는 2023년 5,224개 기관·579,262건, 2024년 5,486개 기관·617,271건, 2025년 5,160개 기관·644,970건을 집계하였으며, 사업연도 종료 후 이듬해로 이월된 집행분(2026년, 2,071개 기관·132,104건)과 과거 이월 잔존분(2020~2022년 15건)을 함께 포함하여 최종 1,973,622건, 7,589개 기관(중복 제거)으로 확정하였다. 데이터베이스 접근은 운영 담당자의 적법한 권한 하에 이루어졌으며, 개인정보보호 규정을 준수해 필요한 최소한의 정보만 추출하였다. 카드번호는 비식별화, 기관명은 익명화하여 표기하였다.
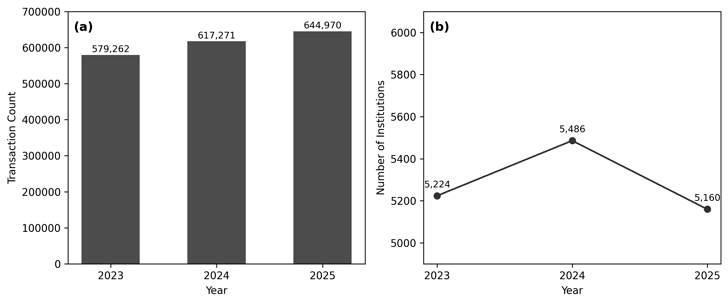
Trends in transaction count and number of institutions by year (a) Number of transactions by year, (b) Number of institutions by year
4.2 결과
탐지 방법별 결과는 그림 2와 같다. 규칙 기반 탐지는 유형에 따라 489~4,188개로 큰 편차를 보였으며, IF와 LOF는 각각 600개, 2,766개 기관을 이상으로 탐지하였다. 공통 탐지 기관은 462개로, 중복률은 IF 기준 77.0%, LOF 기준 16.7%로 기준 집합에 따라 크게 달라졌다.
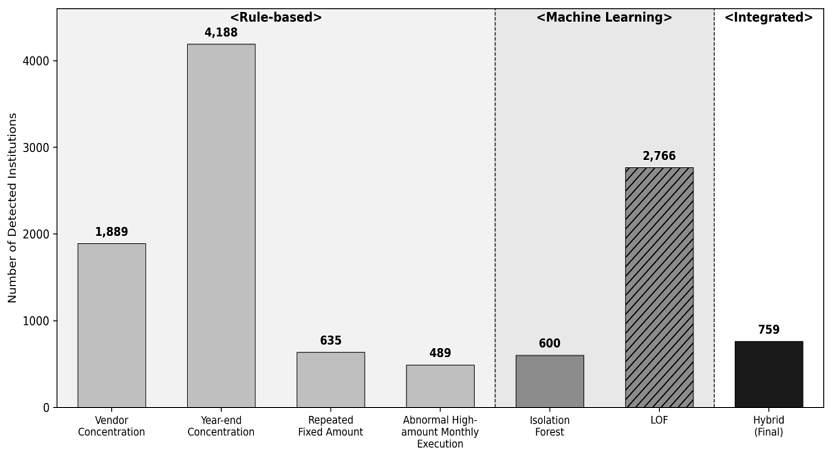
Number of flagged institutions by detection method
이는 두 알고리즘이 서로 다른 기준으로 이상 신호를 포착하며, 상호 보완적임을 시사한다. 또한 대학교·연구소는 IF 이상·반복고정금액·비정상고액월간집행 등 정량적 지표에서, 기업·공공기관은 연말집중집행·특정 거래처 집중거래 등 규칙 기반 지표에서 상대적으로 높은 탐지 비중을 보였는데, 이는 기관 규모나 과제 수 같은 다른 요인은 따로 살펴보지 않은 결과이다. 전체 기관의 종합위험지수는 그림 3과 같다. 평균 50.6점, 중위값 51.2점이었으며, 이 중 약 9.1%의 기관이 낮은 위험 지수(0~30점)를 나타내었다.
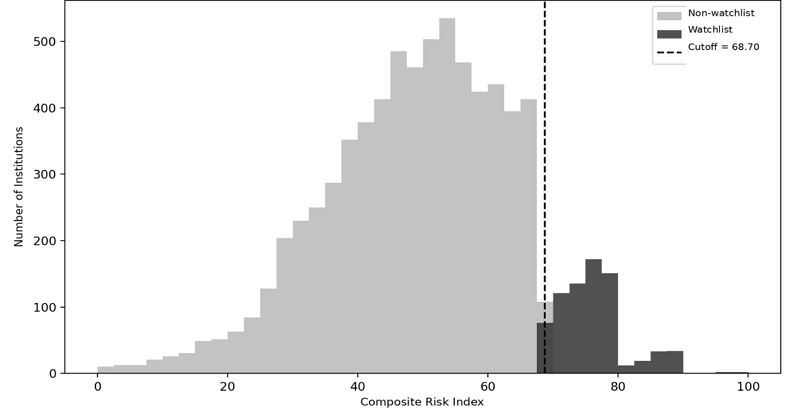
Distribution of composite risk index(cutoff=68.70)
종합 위험 지수 기준 상위 10%인 759개 기관을 최종 주의기관으로 분류하였으며(그림 2), 이들은 모두 하나 이상의 규칙 기반 패턴을 동반하였다. 규칙 기반 이상징후가 없으면서 IF·LOF에서만 이상 신호가 나타난 721개 기관은 종합 위험 지수가 컷오프(68.70점)에 도달하지 못해 최종 주의기관에 포함되지 않았다. 이는 규칙 기반 패턴이 전혀 없는 기관의 경우 IF·LOF 점수가 모두 최고치(각 100점)이더라도 종합 위험 지수가 이론상 최대 60점(0.3×100+0.3×100)에 그쳐 컷오프에 도달할 수 없는 현재의 가중치 구조에서 비롯되며, 이는 통계적으로만 이상 신호를 보이는 기관보다 규정 위반 패턴을 동반한 기관을 우선 선별하기 위한 의도된 설계이다.
즉 IF·LOF는 새로운 주의기관을 독자적으로 추가하기보다, 규칙 기반으로 이미 탐지된 기관들 사이에서 상대적 위험 순위를 조정하는 데 주로 기여한다. 탐지 방법 간 중복도(Jaccard 유사도)는 그림 4와 같으며 연말집중집행과 LOF 이상(0.309), 비정상고액월간집행과 IF 이상(0.290)의 상관이 상대적으로 높게 나타나, 특정 규칙 유형과 특정 ML 알고리즘 간에 부분적인 대응 관계가 존재함을 확인하였다.
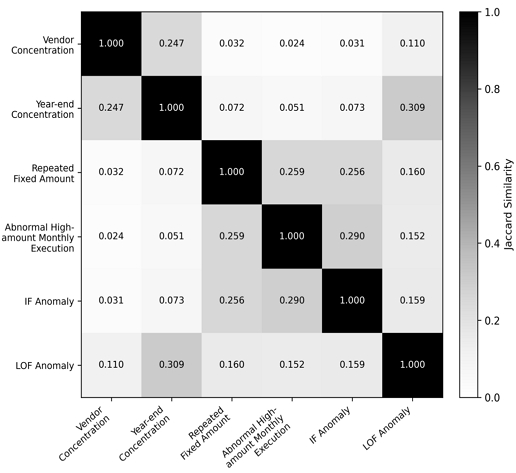
Overlap between anomaly types(Jaccard similarity)
이러한 위험순위 조정은 규칙 기반 지표와 무관하지 않게 나타났다. 정식 규칙 유형은 아니지만 수의계약 한도 인근 반복 집행을 포착하는 보조 지표인 임계근접발생일수가 3일 이상인 기관 100개 중 97개(97.0%)를 IF·LOF는 양쪽에서 모두 이상으로 탐지하였는데, 이는 전체 기관의 IF·LOF 공통 탐지 비율(6.1%)보다 약 16배 높은 수준이다. 이는 IF·LOF가 완전히 독립적인 신호가 아니라, 규칙 기반 지표와 유사한 방향의 패턴을 포착하고 있음을 시사한다. 종합위험지수 상위 20개 기관은 그림 5와 같다. IF 백분위점수(69.0~99.9)와 LOF 백분위점수(93.8~96.5)가 모두 고르게 높아 두 알고리즘이 상호 보완적으로 작동함을 뒷받침하였으며, 기관 유형별로는 대학교가 7개로 상위 20개 중 가장 많은 비중을 차지하였고, 기타가 5개, 연구소가 3개로 뒤를 이었다.
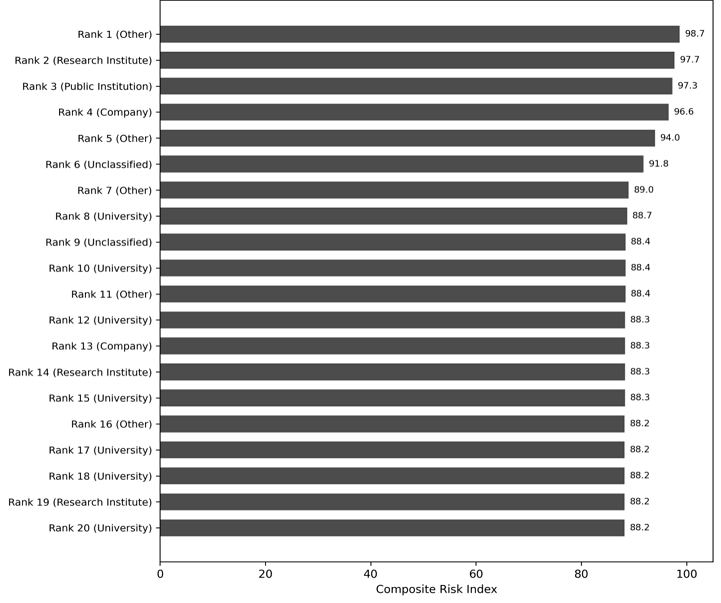
Top 20 institutions by composite risk index
기관 유형별 주의기관 선정 비율은 표 2와 같으며, 대학교·연구소에서 전체 평균(10.0%)을 크게 상회하는 비율이 관찰되었다. 다만 이러한 차이가 실제 부정 집행의 많고 적음을 의미하는지는 확인되지 않았으며, 기관 유형별 집행 특성을 반영한 추가 분석이 필요하다. 탐지 결과가 조건 변화에도 일관되게 유지되는지 점검하기 위해, 서로 다른 조건에서 선정된 상위 기관 집합이 얼마나 겹치는지를 나타내는 Jaccard 유사도를 산출하였다. 그 결과 피처셋·정규화 방식 변경에는 비교적 견고하였으나(Jaccard 0.841~1.000), LOF의 이웃 수(n_neighbors) 설정을 바꾸거나 분석 연도를 바꾸면 선정되는 기관 집합이 크게 달라졌다(Jaccard 각각 0.002~0.321, 0.25 내외).
Watchlist ratio by institution type
가중치 설정의 견고성을 확인하기 위해 40:30:30 외에 50:25:25, 34:33:33, 60:20:20 등 대안 가중치 조합에 대해 상위 5%, 10%, 15% 기관 집합의 Jaccard 유사도를 비교하였다. 그 결과 40:30:30과 인접한 조합들은 0.62~0.91 수준의 유사도를 보여 가중치의 미세한 조정에는 비교적 안정적이었으나, 규칙 기반 비중을 크게 높인 60:20:20 조합에서는 상위 15% 기준 유사도가 0.618까지 낮아지는 등 일부 조합에서 민감도가 나타났다. 이는 종합 위험 지수가 기관에 고정된 속성이라기보다, 해당 연도의 집행 특성을 반영하는 유동적인 지표에 가깝다는 것을 시사한다.
4.3 기존 연구와의 비교
기존 연구와 비교하면 차별점이 명확하다. 인공신경망 기반 지도학습 접근법[11]은 레이블된 학습 데이터가 필요하여 실제 점검 결과가 축적되지 않은 도입 초기에는 적용이 제한적인 반면, 레이블 없이도 규칙 기반 지식과 비지도 학습을 결합해 즉시 적용할 수 있다. 또한 군집분석과 Isolation Forest를 결합한 기존 연구[12]가 단일 조합의 이상 궤적 탐지에 초점을 두었다면, 규칙 기반 탐지와 IF·LOF 두 비지도 알고리즘을 함께 결합하여 서로 다른 기준의 이상 신호(중복률 16.7~77.0%)를 폭넓게 포괄하였다. 아울러 197만여 건의 실 데이터와 7,589개 기관을 대상으로 한 대규모 실증 적용은 실무 도입 가능성을 뒷받침한다.
Ⅴ. 결 론
본 논문에서는 규칙 기반 탐지와 머신러닝을 결합한 혼합 이상탐지 모델을 실제 연구비 집행 데이터에 적용하여 상위 10% 기준 759개 기관을 주의기관으로 선정하였다. 탐지 방법 간 서로 다른 기관 집합이 식별되는 경향과 규칙 미탐지 기관의 컷오프 미달 결과는 규칙 기반 탐지 결과를 기준으로 머신러닝이 우선순위를 재정렬하는 구조임을 보여준다. 이러한 특성으로 인해 제한된 점검 인력을 상대적으로 위험도가 높은 기관에 우선 배분하는 실무적 점검 도구로 활용될 수 있다.
다만 몇 가지 발전 방향이 남아 있다. 본 연구는 레이블 데이터 없이 비지도 방식으로 이상 패턴을 탐지한다는 점에서, 실제 점검 결과를 축적함으로써 탐지 성능을 정량적으로 검증하고 모델을 지속적으로 개선할 수 있다. 또한 규칙 임계값과 머신러닝 하이퍼파라미터는 현 시점의 데이터와 전문가 판단에 기반한 것으로, 데이터가 누적될수록 더욱 정밀한 최적화가 가능해질 것이다. 가중치 구조(40:30:30) 역시 점검 정책의 우선순위가 명확해짐에 따라 실증적 근거를 갖춘 형태로 발전시킬 수 있다. 향후 연구에서는 이러한 가능성을 실현하는 동시에, 설명 가능 AI 기법의 접목과 실시간 모니터링 체계로의 확장을 통해 연구비 관리의 투명성과 효율성을 높이고자 한다.
Acknowledgments
이 논문은 2024학년도 국립한밭대학교 교내학술연구비의 지원을 받았음
References
-
F. T. Liu, K. M. Ting, and Z. H. Zhou, "Isolation forest", Proc. 2008 Eighth IEEE International Conference on Data Mining, Pisa, Italy, pp. 413-422, Dec. 2008.
[https://doi.org/10.1109/ICDM.2008.17]

-
M. M. Breunig, H. P. Kriegel, R. T. Ng, and J. Sander, "LOF: Identifying density-based local outliers", Proc. 2000 ACM SIGMOD International Conference on Management of Data, Dallas, TX, USA, pp. 93-104, May 2000.
[https://doi.org/10.1145/342009.335388]
-
V. Chandola, A. Banerjee, and V. Kumar, "Anomaly detection: A survey", ACM Computing Surveys, Vol. 41, No. 3, pp. 1-58, Jul. 2009.
[https://doi.org/10.1145/1541880.1541882]
-
C. C. Aggarwal, "Outlier Analysis", 2nd ed., Springer, Cham, Switzerland, 2017.
[https://doi.org/10.1007/978-3-319-47578-3]
-
J. W. Kim, S. R. Jung, and N. K. Kim, "Comparison of anomaly detection algorithm performance: From the perspective of outlier types and data properties", Journal of Intelligence and Information Systems, Vol. 29, No. 3, pp. 229-247, Sep. 2023.
[https://doi.org/10.13088/jiis.2023.29.3.229]
-
G. W. Ko, B. H. Cho, Y. J. Byun, and D. H. Yoo, "A comparative study on outlier detection for unsupervised learning-based sensor data", Journal of the Korean Data & Information Science Society, Vol. 34, No. 4, pp. 619-634, Jul. 2023.
[https://doi.org/10.7465/jkdi.2023.34.4.619]
-
M. Goldstein and S. Uchida, "A comparative evaluation of unsupervised anomaly detection algorithms for multivariate data", PLoS ONE, Vol. 11, No. 4, Art. no. e0152173, Apr. 2016.
[https://doi.org/10.1371/journal.pone.0152173]
-
M. Ahmed, A. N. Mahmood, and M. R. Islam, "A survey of anomaly detection techniques in financial domain", Future Generation Computer Systems, Vol. 55, pp. 278-288, Feb. 2016.
[https://doi.org/10.1016/j.future.2015.01.001]
- R. Chalapathy and S. Chawla, "Deep learning for anomaly detection: A survey", arXiv:1901.03407, , Jan. 2019.
-
J. W. Lim and J. G. Lee, "Performance comparison of unsupervised learning models for anomaly detection in multivariate time-series tasks", Journal of the Korea Institute of Information Security & Cryptology, Vol. 33, No. 1, pp. 1-12, Feb. 2023.
[https://doi.org/10.13089/JKIISC.2023.33.1.1]
-
J. W. Lee, J. Kim, J. S. Lee, and M. H. Han, "A study on inappropriate research fund detection model using artificial neurual[sic] network", Journal of Korea Technology Innovation Society, Vol. 22, No. 6, pp. 963-986, Dec. 2019.
[https://doi.org/10.35978/jktis.2019.12.22.6.963]
-
Y. H. Ko, S. Kim, H. T. Lee, J. H. Park, and H. J. Park, "Anomaly trajectory detection using clustering and Isolation Forest", Journal of Korean Institute of Intelligent Systems, Vol. 34, No. 1, pp. 25-35, Feb. 2024.
[https://doi.org/10.5391/JKIIS.2024.34.1.25]
- F. Pedregosa, et al., "Scikit-learn: Machine learning in Python", Journal of Machine Learning Research, Vol. 12, pp. 2825-2830, Oct. 2011.
2018년 2월 : 국립한밭대학교 컴퓨터공학과(공학사)
2022년 9월 ~ 현재 : 한국연구재단 연구원
2025년 3월 ~ 현재 : 국립한밭대학교 컴퓨터공학과 석사과정
관심분야 : 이상탐지, 머신러닝, 데이터마이닝
1998년 2월 : KAIST 전기및전자공학과(공학사)
2000년 2월 : KAIST 전자전산학과(공학석사)
2005년 2월 : KAIST 전자전산학과(공학박사)
2007년 9월 ~ 현재 : 국립한밭대학교 컴퓨터공학과 교수
관심분야 : 인공지능 응용, 지능형 네트워크 프로토콜, 앱웹 서비스