단편 서사 생성을 위한 다중 채널 프롬프팅을 활용한 구조화 지식 중개 모델
 ; 유리**
; Ri Yu**
초록
최근 LLM 기반 생성형 인공지능 활용이 확대되고 있으나, 자연어 프롬프트의 모호성으로 인해 사용자 의도와 생성 결과 간 불일치가 발생하고 있다. 본 연구에서는 단편 서사 생성에서 캐릭터, 분위기, 서사 구조 등 창작 의도 정보를 효과적으로 전달하기 위한 다중 채널 프롬프팅을 활용한 구조화 지식 중개 모델을 제안한다. 제안 모델은 창작 정보를 지식 채널로 구성하고 구조화 프롬프트로 변환하여 LLM에 전달함으로써, 사용자가 지정한 핵심 요구사항이 생성 결과에 일관되게 반영될 수 있도록 한다. 실험 결과, 구조화 정보가 제공된 조건에서 캐릭터와 분위기 일관성이 베이스라인 대비 각각 0.25점, 0.21점 높은 값으로 나타났으며, 서사 구조 준수도는 0.90으로 나타났다. 이러한 결과는 구조화된 정보의 제공이 LLM 기반 서사 생성에서 사용자 의도의 일관된 반영에 기여할 수 있음을 보여준다.
Abstract
As LLM-based generative AI advances, ambiguous natural language prompts can cause mismatches between user intentions and generated outputs. This study proposes a structured knowledge mediation model using multi-channel prompting to convey creative intent, including character, mood, and narrative structure, in short narrative generation. The model organizes creative information into knowledge channels and converts it into structured prompts to consistently reflect user requirements. Experiments show that character and mood consistency improved by 0.25 and 0.21 points over the baseline, respectively, while narrative structure compliance reached 0.90. These findings highlight the potential of structured information to improve user intent alignment in LLM-based narrative generation.
Keywords:
LLM, multi-channel prompting, structured knowledge mediation model, short narrative generationⅠ. 서 론
오늘날 LLM(Large Language Model)의 발전과 함께 AI의 활용은 일상 전반으로 확산되어 다양한 분야에서 폭넓게 이루어지고 있다[1]. LLM은 일상적인 자연어를 이해하고, 결과물을 자연어로 제공함으로써 사용자가 별도의 사용법을 학습하지 않고도 AI를 활용할 수 있도록 하여 대중적 접근성을 높였다. 그러나 사용자 의도와 생성 결과 간 정합성은 여전히 해결해야 할 과제로 남아 있다.
양질의 결과물을 획득하기 위해서는 문제를 명시화하고 입력값과 출력값에 대한 규약을 지정해야 하며, 문제 해결과정에서의 다양한 예외사항들에 대한 처리 방법과 처리 규칙들이 선결되어야 한다. 이는 단순한 자연어 명령의 입력만으로는 충분히 표현하기 어렵다. 소프트웨어 모듈 설계에서는 하나의 단위 기능을 입력값, 출력값, 그리고 수행절차 등의 요소로 명세한다. 이를 통해 사용자는 생산된 결과가 자신의 의도대로 도출되었는지를 확인할 수 있다. 하지만 이러한 정보들이 자연어로 표현된 사용자의 지시사항에 제공되지 않는다면 LLM은 명시되지 않은 정보를 학습된 지식과 확률적 생성 과정에 기반하여 보완하게 된다. 이때 LLM의 보완 결과가 사용자가 명시적으로 표현하지 못한 의도와 일치하지 않을 경우, 사용자는 자신의 의도와 다른 결과를 얻을 수밖에 없다.
이와 같은 사용자와 LLM 간의 의도 차이는 AI의 신뢰성 및 사용자 만족도를 저해하는 요인으로 작용하지만, 이러한 결과는 단순한 오류가 아니라 자연어 처리 과정에서 발생하는 표현의 모호성에 근거한 논리적 산물로 이해할 필요가 있다. AI가 이해할 수 있도록 자신의 요구사항을 명확하게 기술하는 방법을 프롬프트 엔지니어링이라고 부르며, 이는 전통적인 요구사항 분석 과정에서 수행하는 의도 명확화 과정과 유사한 측면이 있다. 그러나 자연어 기반 요구사항 표현은 전통적인 요구사항 분석 과정에서 수행되는 상세한 명세가 충분히 이루어지지 않을 수 있으며, 이러한 생략은 표현의 모호함을 증가시킨다. 결국 자연어만으로 사용자의 의도를 완전히 명시하는 데에는 본질적인 한계가 존재하므로 본 연구에서는 자연어 프롬프트의 단점을 보완하기 위한 다중 채널을 사용하는 지식 중개 모델을 제안한다. 이 중개 모델을 통해 자연어 이외의 다양한 보조 채널을 이용해 사용자의 요구사항을 구조화하고, 이렇게 구조화된 요구사항을 LLM에 투입함으로써 자연어의 한계를 보완할 수 있다. 다만, 보조 채널의 결합은 문제 도메인의 특성에 따라 달라지며 문제 자체의 특성에 영향을 받기도 한다.
본 연구는 일반 문제 상황에서 자연어 프롬프트를 보조하는 멀티 채널 프롬프트 조합의 한 사례로 단편 서사 창작 문제를 선정하고, 이를 위한 멀티 채널 설계 방법의 적용을 제안한다. 또한 제안한 방법을 적용하여 개별 사용자의 자연어 프롬프트 작성 능력과 관계없이 보조 채널을 통해 획득한 정보를 활용함으로써 자연어 명령을 보완하고, 일관되고 안정적인 결과 생성을 지원하는 프롬프트를 생성하여 최종 결과를 제공하는 지식 중개 시스템을 구현하였다. 본 연구에서 말하는 일관성은 사용자가 의도한 핵심 요구사항이 생성 결과에 지속적으로 반영되는 특성으로 정의한다. 또한 안정성은 구조화된 입력 정보가 자연어 프롬프트로 변환되는 과정에서 원래의 의미 정보가 유지되는 정도로 정의한다.
Ⅱ. 관련 연구
2.1 LLM 기반 프롬프팅 활용 기법
LLM은 기본적으로 자연어를 통해 사용자와 상호작용한다. 이때 사용자의 요구사항을 효과적으로 전달하기 위한 입력 설계 방법을 프롬프트 엔지니어링이라고 한다. 대표적인 프롬프트 엔지니어링 방법들은 다음과 같다[2]. 시스템, 사용자, 어시스턴트 등의 역할을 명확히 구분하여 LLM이 수행해야 할 관점과 목적을 설정하는 역할 기반 프롬프팅, 수행해야 할 작업의 목표와 절차를 명시하는 작업 지시, 작업 과정에서 지켜야 하는 규칙이나 제약을 명시하는 제약 조건 설정, 출력 형식을 지정하여 생성 결과의 형태를 제어하는 출력형식 지정이 그것들이다. 이와 더불어 LLM의 생성 성능과 일관성을 향상시키기 위해 다양한 추가 정보 제공 방식 또한 연구되고 있다. 퓨샷 프롬프팅은 입력과 출력의 예제를 제공하여 LLM이 원하는 패턴을 학습하도록 유도하며, 사고 과정 기반 프롬프팅은 문제 해결 과정에 대한 추론 단계를 유도하여 복잡한 문제 해결 성능을 향상시키는 방식이다.
그러나 이러한 기존 프롬프트 엔지니어링 방식은 결국 사용자가 자신의 요구사항, 즉 목표를 명확하게 이해하고 그것을 적절한 형태로 표현할 수 있다는 것을 가정하고 있다. 어떤 단계로 진행해야 하는지, 어떤 역할에 근거하여 답변을 생성해야 하는지, 어떤 형식과 제약을 지켜야 하는지를 명시하지 못한다면 기대한 것과 다른 생성 결과가 만들어질 가능성이 존재한다[3].
2.2 단편 서사의 주요 구성 요소
서사 문학은 다양한 서사 기법을 통해 인물의 정신세계를 창의적으로 재현한다[4]. 특히 서사는 인간의 언어 능력을 기반으로 구성되는 창작 활동이라는 점에서 LLM의 언어 생성 능력을 평가하고 활용하기 위한 적절한 도메인으로 볼 수 있다. 그러나 서사 생성은 단순한 문장의 생성이 아니라 인물, 사건, 배경, 분위기 등 다양한 요소가 상호작용하여 의미를 구성하는 과정이므로, 사용자의 의도를 자연어만으로 명확하게 전달하기 어려운 영역이다.
롤랑 바르트는 서사의 의미 형성 방식을 설명하기 위해 행위(Proairetic), 수수께끼(Hermeneutic), 의미(Semic), 상징(Symbolic), 그리고 문화(Cultural)를 제시하였다[5]. 행위는 사건의 연쇄적 전개를 통해 서사의 진행을 구성하는 요소이며, 수수께끼는 이야기 속 미해결 질문과 그 해답의 지연을 통해 긴장감을 형성한다. 의미는 인물 혹은 사건, 배경에 부여된 특징을 나타내며, 상징은 이야기의 심층적 의미를 드러낸다. 마지막으로 문화는 독자가 이야기의 맥락을 이해할 수 있도록 하는 공유된 지식 체계를 의미한다. 요컨대 이야기는 인물의 경험과 맥락을 통해 독자의 이해와 공감을 이끌어낼 때 비로소 완성도 높은 서사로 평가될 수 있다. 이는 서사가 단순한 사건의 나열이 아니라 다양한 요소 간 관계를 통해 의미를 형성하는 구조임을 보여준다.
본 연구에서는 문학적 서사 구성 요소를 시스템에서 구현 가능한 단위로 구체화하고, 사용자 의도를 구조화하여 생성 과정에 반영하기 위한 주요 제어 요소로 캐릭터, 분위기, 서사 구조를 선정하였다. 인물은 서사 내에서 사건을 경험하고 행동을 수행하는 주체이며, 인물의 성격과 특징은 사건 전개와 결과의 개연성에 영향을 미친다. 본 연구에서는 이러한 성격과 특징을 가진 주체를 캐릭터 요소로 변환하였다. 분위기는 작품 전체의 정서적 방향성을 결정하는 요소로, 동일한 사건이라도 분위기에 따라 인물의 행동과 사건의 해석 방식이 달라질 수 있다. 또한 서사 구조는 사건의 배열과 긴장도 변화를 통해 이야기의 흐름과 독자의 몰입을 형성하는 요소이다. 따라서 본 연구에서는 단편 서사 생성을 위한 구조화 지식 모델을 설계하기 위해 캐릭터, 분위기, 서사 구조를 독립적인 지식 채널로 구성하고 이를 생성 과정의 입력 정보로 활용한다.
Ⅲ. 구조화 지식 중개 모델
3.1 구조화 지식 중개 모델 개념
기존 생성형 AI 서비스는 사용자의 자연어 입력을 기반으로 LLM이 의도를 추론하고 결과를 생성하지만 자연어 명령의 모호성으로 인해 사용자 의도와 다른 결과가 생성될 수 있다. 이러한 부족한 정보는 LLM의 학습 데이터와 확률적 추론을 통해 보완되지만 생성 결과의 일관성과 적합성을 저하시키는 한계가 있다.
본 연구에서는 이러한 문제를 개선하기 위해 사용자 입력과 생성 모델 사이에 구조화 지식 중개 모델을 추가하는 구조를 제안한다. 그림 1은 제안 모델의 개념도이다. 우선 도메인 전문가는 도메인 지식을 프레임 기반의 구조화된 지식 구조로 명시화한다. 중재자는 구조화된 도메인 지식을 바탕으로 사용자가 도메인 정보를 입력할 수 있는 다양한 UX 채널을 구성한다. 이를 통해 사용자는 도메인에서 필요로 하는 내용을 자연어를 비롯해 중재자가 제시하는 다양한 UX 채널을 사용해서 표현할 수 있게 된다. 특히 사용자가 전문적인 프롬프트 작성 방법이나 도메인 지식의 세부적인 표현 방식에 익숙하지 않더라도, 중재자가 제공하는 구조화된 입력 항목과 선택지를 통해 생성에 필요한 주요 정보를 구체적으로 입력할 수 있도록 구성하였다. 본 연구의 적용 시스템에서는 사용자가 배경, 캐릭터 외형, 주제 등의 일부 정보를 자연어로 입력하고, 캐릭터의 성향, 분위기, 서사 구조 등 주요 창작 요소는 구조화된 입력 채널을 통해 제공하도록 구성하였다. 중재자는 이렇게 여러 채널들을 통해 수집된 사용자의 의도를 취합하여 사전에 정의된 프롬프트 템플릿에 입력값을 삽입하고, 생성 모델에 전달할 최종 자연어 프롬프트를 구성한다. 이 과정은 별도의 LLM이 프롬프트를 생성하는 방식이 아니라, 프롬프트 생성 모듈을 통해 구조화된 입력 정보를 사전에 정의된 형식에 따라 최종 프롬프트에 반영하는 방식으로 구현하였다. 이를 통해 사용자가 직접 작성해야 하는 자연어 프롬프트의 범위를 제한하고, 구조화된 입력 정보를 생성 과정에 반영할 수 있도록 하였다. 따라서 제안 모델에서 중재자는 사용자의 입력을 도메인 지식에 기반한 구조화된 정보와 자연어 정보로 취합하고, 이를 생성 모델에 전달하는 중개 역할을 수행한다. 중재자는 상호작용 대상에 따라 다음의 두 단계 과정에 참여한다. 첫 번째 단계는 도메인 지식 구축 단계이며, 두 번째 단계에서는 중재자가 구조화 지식을 활용하여 사용자 입력 환경을 구성하고, 수집된 정보를 검증한 후 프롬프트 생성 모듈을 통해 생성 모델에 전달할 최종 프롬프트를 구성한다. 각 단계의 주요 과정은 표 1과 같다.
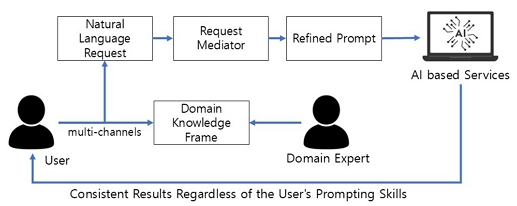
Conceptual diagram of the proposed model

Process of the proposed structured knowledge mediation model
첫 번째 단계에서 도메인 전문가는 대상 도메인의 특성을 분석하고, 생성 결과에 영향을 미치는 요소를 선정 및 모델링한다. 이후 정의된 요소와 관계 정보를 기반으로 구조화 지식이 생성된다. 두 번째 단계에서는 중재자가 구조화 지식을 활용하여 사용자 입력 환경을 구성하고, 수집된 정보를 검증하여 생성 모델에 전달할 프롬프트를 생성한다.
3.2 단편 서사 생성을 위한 구조화 지식 모델
구조화 지식 중개 모델의 첫 번째 단계는 대상 도메인의 특성을 분석하고, 생성 결과에 영향을 미치는 핵심 요소를 선정하여 구조화하는 과정이다. 본 연구에서는 생성형 AI 기반 단편 서사 생성을 대상으로 하였으며 캐릭터, 분위기, 서사 구조를 주요 제어 요소로 선정하였다. 이는 단편 서사의 생성 과정에서 사용자의 의도와 생성 결과의 특성을 비교적 직접적으로 연결할 수 있는 요소라는 점을 고려한 것이다. 또한 단편 서사는 동일한 사건이라 하더라도 등장인물의 특성, 사건이 발생하는 환경, 그리고 사건의 전개 방식에 따라 서로 다른 의미와 결과를 생성할 수 있다. 따라서 본 연구에서는 이러한 요소들을 구조화된 지식 형태로 표현하고, 중재자가 사용자 입력과 결합하여 생성 모델의 입력으로 활용할 수 있도록 모델링하였다.
서사 생성에서 인물은 사건을 경험하고 행동을 수행하는 주체로서, 생성 결과의 개연성과 일관성을 결정하는 핵심 요소이다[6][7]. 그러나 생성형 AI를 활용한 서사 생성 환경에서는 인물을 자연어로 기술할 경우에 동일한 인물에 대해서도 성격이나 행동 패턴이 다르게 생성될 수 있다. 이에 본 연구에서는 서사의 해심 구성 요소인 인물을 시스템에서 구현 가능한 단위인 캐릭터로 정의하고, 이를 외형 및 사회적 관계를 포함하는 정량적 속성과 내적 특성을 표현하는 정성적 속성으로 구분하여 구조화하였다.
정량적 속성은 캐릭터를 외부적으로 식별할 수 있는 시각적 특징과 사회적 영향력으로 구성된다. 시각적 특징은 성별, 신체적 특징, 의상 등 캐릭터의 외형적 특성을 포함하며, 생성 과정에서 캐릭터의 모습을 일관되게 유지하기 위한 정보로 활용된다. 또한 사회적 영향력은 캐릭터가 주변 인물들과 형성하는 관계적 위치를 표현하기 위해 사용되며, 주변의 지지도와 개인의 매력을 기반으로 하는 2차원 벡터로 표현하였다.
사회적 영향력 벡터는 두 축의 조합을 통해 캐릭터의 사회적 위치를 표현한다. 예를 들어 (0,0)은 주변 인물로부터 인정받지 못하는 소외형 캐릭터를 의미하며, (0,10)은 높은 영향력을 가지고 있으나 지지 기반이 부족한 독재자 유형을 나타낸다. 반면 (10,0)은 매력은 부족하지만 주변의 도움을 받는 친화적 유형이며, (10,10)은 높은 매력과 사회적 지지를 동시에 가진 지도자 유형으로 해석된다.
정성적 속성은 캐릭터의 행동 원인을 설명하기 위한 내적 동기와 태도로 구성된다. 내적 동기는 캐릭터가 특정 행동을 수행하는 근본적인 가치와 목적을 의미하며, 태도는 이러한 동기가 실제 행동 방식으로 표현되는 경향성을 의미한다. 예를 들어 동일하게 복수를 목표로 하는 캐릭터라도 외향적이고 충동적인 성향을 가진 경우 직접적인 대결을 선택할 수 있으며, 내향적이고 계획적인 성향을 가진 경우 은밀한 방식의 복수를 선택할 수 있다.
본 연구에서는 캐릭터의 태도를 정량적으로 표현하기 위해 Big5 성격 모델의 개념을 참고하여 개방성, 성실성, 외향성, 우호성, 정서적 안정성 요소를 기반으로 5개의 차원을 구성하였다. Big5는 성격 요소를 수치화하기 적합하다는 장점이 있으나 일반 사용자가 직접 캐릭터 성격을 지정하기에는 어려움이 존재한다. 이에 따라 사용자 입력 과정에서는 MBTI 기반 표현을 함께 활용하였다. MBTI는 심리학적 성격 측정 및 진단 도구로서 학술적 타당성과 활용에 대한 한계가 지적되어 왔다. 다만 본 연구에서는 이를 인간의 실제 성격 특성을 측정하거나 심리적 특성을 진단하기 위한 도구로 활용하는 것이 아니라 일반 사용자에게 비교적 친숙하게 사용되는 성향의 표현 방식을 활용하여 캐릭터의 특성을 직관적으로 지정할 수 있도록 하기 위한 보조적 표현 수단으로 적용하였다. 이를 통해 정의된 캐릭터 모델 구조는 표 2와 같다. 또한 캐릭터의 태도 요소는 특정 내적 동기를 형성하는 기반 요소로 활용된다. 본 연구에서는 복수(Revenge), 구원(Redemption), 호기심(Curiosity), 인정(Recognition), 생존(Survival)의 다섯 가지 내적 동기를 정의하고, 태도 요소와의 관계를 휴리스틱 규칙으로 모델링하였다. 각 내적 동기와 태도 요소 간의 관계는 표 3에 제시하였다. 이러한 관계는 고정된 심리 모델을 의미하는 것이 아니라, 생성 과정에서 캐릭터 행동의 일관성을 유지하기 위한 지식 제약으로 활용된다.
Model structure for describing character
Heuristic relationship between character motivation and attitude
분위기는 개별 인물의 감정 상태를 넘어, 서사의 시공간적 구성과 가치 체계가 형성하는 작품 전체의 정서적 방향성을 의미한다[8]. 동일한 사건이라도 작품의 분위기에 따라 사건의 의미와 표현 방식은 달라질 수 있으며, 이는 인물의 행동 방식과 문체 선택에도 영향을 미친다. 따라서 본 연구에서는 분위기를 단순한 감정 값이 아니라 생성 결과를 조절하는 구조화된 제약 요소로 정의하였다.
본 연구에서는 분위기를 잔혹성(Violence), 환상성(Fantasy), 활동성(Activity level), 정서적 톤(Tone), 교훈성(Lesson)의 다섯 가지 차원으로 표현하였다. 각 요소는 0~10 범위의 값으로 표현되며, 사용자는 해당 속성을 조절함으로써 생성되는 이야기의 정서적 방향성을 지정할 수 있다.
잔혹성은 갈등과 폭력 표현의 수준을 조절하며, 환상성은 현실적 요소와 초자연적 요소의 비중을 결정한다. 활동성은 사건 전개의 속도와 문장 표현 방식에 영향을 주며, 정서적 톤은 이야기의 정서적 방향을 결정한다. 마지막으로 교훈성은 결말에서 주제나 메시지가 얼마나 명확하게 드러나는지를 조절한다. 각 분위기 요소의 정의와 조절 기준은 표 4에 제시하였다.
Mood modeling and expression of model intensity
이러한 분위기 모델은 단순한 스타일 선택이 아니라 생성 과정에서 문체와 표현 방식에 영향을 미치는 제약 조건으로 동작한다. 예를 들어 높은 활동성은 짧은 문장과 동작 중심 표현을 유도하며, 높은 교훈성은 결말에서 주제와 메시지가 명확하게 드러나는 방향으로 생성 결과를 조절한다.
캐릭터와 분위기가 결정된 이후에는 사건을 어떠한 흐름으로 전개할 것인지에 대한 서사 구조가 필요하다. 서사 구조는 사건의 배열뿐 아니라 이야기 진행 과정에서 발생하는 긴장도의 변화를 결정하며, 독자의 몰입을 유도하는 중요한 요소이다.
본 연구에서는 하나의 고정된 서사 구조를 선택하는 대신, 다양한 서사 구조를 조합하여 생성 가능한 구조로 모델링하였다. 이를 위해 기승전결[9], 키쇼텐케츠[10], 조셉 캠벨의 영웅 서사[11], 구스타프 프라이타크의 피라미드 구조[12]를 주요 서사 모델로 선정하였다. 기승전결 구조는 사건의 도입, 전개, 전환, 결말이라는 명확한 인과 관계를 기반으로 하며, 키쇼텐케츠는 직접적인 갈등보다 새로운 요소의 등장과 통합을 통해 변화를 생성하는 구조이다. 영웅 서사는 주인공의 성장과 시련 극복 과정을 중심으로 하며, 프라이타크 구조는 클라이맥스를 중심으로 긴장도가 상승하고 감소하는 형태를 가진다. 이처럼 다양한 서사 구조가 존재하지만 핵심은 이야기를 수용하는 소비자의 몰입에 있으며, 이는 서사 구조의 적절성을 판단하는 기준이 된다. 따라서 서사 구조의 목표는 긴장감 조성을 통한 소비자의 몰입 유도라고 볼 수 있다. 그렇기에 하나의 구조를 선택하기보다는 독자와 이야기에 따라 적합한 긴장도 변화 양상을 설계하고, 의도한 긴장감을 유발할 수 있는 문장 표현력을 응용하는 것이 중요하다.
본 연구에서는 각 서사 구조가 가지는 긴장도 변화 패턴을 가중치 기반의 선형 결합을 통해 최종 서사 곡선을 생성한다. 단편 이야기인 만큼 총 n(기본값 10)개의 장면을 기준으로, 4개의 기본 서사의 긴장도 곡선을 사용자가 명시적으로 지정한 가중치에 따라 결합한다. 결합 식은 (1)과 같으며, i는 각 장면의 인덱스를 의미하고, k는 4개의 기본 서사 구조, 그리고 w는 가중치를 의미하며, 4개의 가중치의 합은 1이 된다.
| (1) |
이렇게 만들어진 각 장면에서의 서사 구조의 결합 곡선은 이야기 진행 위치에 따른 긴장도의 변화를 표현하며, 해당 위치의 변화율은 문체와 표현 방식을 결정하는 기준으로 활용된다. 표 5는 본 연구에서 적용한 문체 및 표현 방식의 기준을 보여준다. 서사 진행 단계에서 긴장도가 증가하는 구간에서는 짧은 문장, 동작 중심 표현, 감각적 묘사를 사용하고, 안정 구간에서는 복합 문장과 심리 묘사를 활용하며, 감소 구간에서는 회고와 정리에 초점을 둔 표현 방식을 적용한다.
Classification of style based on narrative tension
이와 같이 본 연구에서 정의한 서사 구조 모델은 단순히 이야기의 순서를 결정하는 것이 아니라, 생성 과정에서 표현 방식과 긴장 변화를 함께 제어하는 구조화 지식으로 활용된다.
전술한 캐릭터, 분위기 및 서사 구조 모델을 적용하여 단편 서사를 생성하였다. 각 단계별 입력 및 처리 내용과 생성 결과는 표 6과 같다. 표 6의 사용자 입력 중 배경, 주제 및 캐릭터 외형과 같이 자연어로 입력되는 정보는 사용자의 표현 방식에 따라 서로 다른 형태로 입력될 수 있다. 본 연구에서는 이러한 자연어 입력을 최종 프롬프트에 그대로 사용하는 것이 아니라 프롬프트 생성 과정에서 각 입력의 핵심 의미를 중심으로 사전에 정의된 형식의 표현으로 정리한 후, 구조화된 입력 정보와 함께 최종 프롬프트에 반영하도록 구성하였다. 예를 들어 주제는 이야기의 핵심 내용을 나타내는 하나의 문장으로 정리하고, 배경과 캐릭터 외형 역시 생성에 필요한 핵심 요소를 중심으로 표현하도록 하였다.
Generation Example Using the Proposed Method
사용자 입력이 실제 단편 서사 생성에 사용되는 형태로 정제되는 과정의 예시는 표 7과 같다. 이를 통해 사용자의 자연어 표현 방식에 따른 차이를 완화하고, 생성 과정에서 핵심적으로 반영되어야 할 정보를 일관된 형태로 전달할 수 있도록 하였다.
Results of refining natural language theme inputs
Ⅳ. 실험 및 결과
4.1 실험 환경
제안 모델의 효과를 검증하기 위해 두 가지 실험을 진행하였다. 첫 번째 실험은 구조화된 도메인 지식이 생성 결과의 일관성에 미치는 영향을 평가하기 위한 것이며, 두 번째 실험은 구조화된 입력 정보가 자연어 프롬프트로 변환되는 과정에서 원래의 의미 정보를 얼마나 안정적으로 보존하는지를 평가하기 위한 것이다.
실험환경은 Python과 Streamlit을 이용하여 구현하였으며, 생성 모델은 OpenAI GPT-5.4와 Claude Sonnet 5를 사용하였다. 출력을 위해서는 GPT를 사용하였고, 결과를 평가하기 위한 LLM 평가자(LLM-as-a-judge)로는 Sonnet을 사용하였다. 실험은 동일 생성 모델을 동일한 생성 조건에서 수행하여 모델의 성능 차이가 결과에 영향을 미치지 않도록 하였다.
4.2 실험 1 : 구조화 지식 주입에 따른 생성 결과의 일관성 평가
본 실험의 목적은 제안 모델에서 정의한 구조화된 도메인 정보가 반복 생성 과정에서 결과물의 변동성을 감소시키고, 사용자가 의도한 핵심 요소를 지속적으로 반영함으로써 생성 결과의 일관성을 향상시키는지를 검증하는 것이다.
본 실험에서는 동일한 요구사항에 대한 반복 생성 결과에서 주요 특성의 변동성이 낮게 나타나는 정도를 일관성의 평가 기준으로 설정하고, 구조화 정보의 제공 범위를 단계적으로 변화시키면서 생성 결과 간 특성의 변동성을 비교하였다. 실험에서는 구조화 정보의 제공 범위에 따라 표 8에서와 같은 정보 제공 범위를 가지는 네 가지 케이스를 구성하였다.
Scope of structured information provided in each experimental condition
각 조건에서는 동일한 주제와 배경을 기반으로 30회의 단편 서사를 생성하였다. 생성된 결과물은 LLM 기반 평가자 모델을 활용하여 분석하였다. 모든 조건의 생성 결과에 동일한 평가자 모델과 동일한 평가 기준을 적용함으로써, 평가 모델 및 평가 기준의 차이에 따른 영향을 통제하였다.
캐릭터 특성은 표 2에서 정의한 캐릭터 속성 중 정성적 속성 5개 항목으로, 분위기 특성은 표 4에서 정의한 5개 항목으로 구성하였다. 각 생성 결과에 대해 평가자 모델이 각 항목의 값을 추정하여 5차원의 캐릭터 속성 벡터와 5차원의 분위기 속성 벡터를 각각 생성하였다. 반복 생성 과정에서의 일관성을 평가하기 위해 캐릭터와 분위기를 각각 독립적인 5차원 속성 공간으로 구분하여 각 조건에서 생성된 30개의 결과 벡터에 대한 평균 벡터를 계산하고, 각 결과 벡터와 평균 벡터 사이의 유클리드 거리를 산출하였다.
유클리드 거리는 동일한 속성 공간에서 개별 생성 결과와 평균적인 생성 경향 간의 차이를 나타내며, 거리가 작을수록 반복 생성 결과가 유사한 특성을 유지함을 의미한다. 이후 30개 결과에서 산출된 유클리드 거리 중 최댓값을 기준으로 평균 유클리드 거리를 정규화하고, 거리가 작을수록 높은 값을 가지도록 변환하여 일관성 점수를 정의하였다. 일관성 점수는 0~1 범위의 값을 가지며, 값이 클수록 반복 생성 결과가 서로 유사한 특성을 유지함을 의미한다. 일관성 점수는 다음의 식 (2)를 이용해 계산하였다.
| (2) |
여기서 Davg는 각 조건에서 생성된 30개 결과 벡터와 해당 조건의 평균 벡터 사이의 유클리드 거리의 평균이며, Dmax는 이들 30개 유클리드 거리 중 최댓값이다. 캐릭터와 분위기는 각각 별도의 5차원 속성 공간에서 독립적으로 계산한다. 각 조건에서는 30개의 생성 결과를 하나의 표본 집합으로 구성하여 하나의 일관성 점수를 산출하였다. 산출된 결과는 표 9에 제시한 바와 같다.
Comparison of generation consistency according to structured information scope
서사 구조는 캐릭터 및 분위기와 달리 반복 생성 결과 간 변동성을 측정하는 것이 아니라 입력된 구조의 반영 정도를 평가하였으므로 구조 정보가 입력된 Case 3에서만 수행하였다. Case 3에서 생성된 결과에 대해 평가자 모델이 장면별 긴장도 변화를 추정하여 10차원의 서사 곡선을 생성하고, 이를 입력으로 제공한 기준 서사 곡선과 비교하였다. 입력 곡선과 생성 곡선 간의 유사도를 계산하여 서사 구조 준수도를 측정하였다. 값이 클수록 생성 결과가 입력된 서사 구조를 충실하게 반영한 것으로 판단하였다.
본 평가는 생성 결과물 자체의 문학적 우수성을 비교하는 것이 아니라, 구조화된 지식이 생성 과정에서 사용자의 의도를 얼마나 일관되게 유지하고 반영하는지를 확인하기 위한 것이다.
4.3 실험 2 : 구조화 입력 방식의 프롬프트 생성 안정성 평가
두 번째 실험에서는 제안 모델의 프롬프트 생성 단계에서 구조화된 입력 정보가 자연어 프롬프트로 변환되는 과정에서 원래의 의미 정보가 얼마나 안정적으로 보존되는지를 검증하였다. 본 연구에서 안정성은 구조화된 입력 정보가 자연어 프롬프트로 변환되는 과정에서 원래의 의미 정보가 유지되는 정도로 정의한다. 따라서 본 실험에서는 동일한 구조화 입력을 서로 다른 방식의 자연어 프롬프트로 변환하더라도 입력에 포함된 핵심 속성이 얼마나 유지되는지를 안정성의 평가 기준으로 설정하였다.
제안 모델은 사용자가 정의한 캐릭터와 분위기 정보를 정형화된 속성 벡터 형태로 관리하고, 이를 프롬프트 생성 모듈을 통해 사전에 정의된 프롬프트 템플릿에 삽입하여 생성형 AI의 입력으로 활용되는 자연어 프롬프트를 구성한다. 이 과정에서 생성되는 자연어 프롬프트는 표현 방식과 길이에 따라 다양한 형태로 생성될 수 있으나, 입력된 구조화 정보의 의미는 일관되게 유지되어야 한다. 이를 검증하기 위하여 동일한 구조화 정보를 입력한 후, 프롬프트 생성 모듈에 서로 다른 출력 길이 조건을 적용하여 자연어 프롬프트를 구성하였다. 출력 길이 조건은 200자, 400자, 600자의 세 단계로 설정하였다. 본 실험에서는 자연어 표현으로부터 비교적 명확하게 추론 가능한 캐릭터 속성과 분위기 속성을 평가 대상으로 선정하였다. 반면 서사 구조는 장면별 긴장도 변화와 시간적 배열을 포함하는 구조적 정보로, 자연어 프롬프트로 변환된 이후 원래의 수치적 곡선을 직접 복원하기 어렵기 때문에 평가 대상에서 제외하였다.
생성된 자연어 프롬프트는 별도의 생성 과정에 사용하지 않고 평가자 모델에 입력하여 해당 프롬프트에 포함된 캐릭터 및 분위기 정보를 다시 추정하도록 하였다. 이후 평가자 모델이 추정한 속성 벡터와 최초 입력된 구조화 속성 벡터 간의 유사도를 계산하여, 구조화된 입력 정보가 자연어 프롬프트로 변환되는 과정에서 얼마나 유지되었는지를 평가하였다.
평가 지표는 IPS(Information Preservation Score)를 사용하였다. IPS는 원본 구조화 정보 벡터와 자연어 프롬프트로부터 추정된 정보 벡터 간의 유사도를 나타내는 값으로, 값이 클수록 구조화 정보가 자연어 프롬프트 생성 과정에서 더 충실하게 유지되었음을 의미한다. 따라서 IPS는 본 연구에서 정의한 안정성, 즉 구조화된 입력 정보의 의미가 자연어 프롬프트 변환 과정에서 유지되는 정도를 정량적으로 평가하기 위한 지표로 사용하였다. 이 유사도를 계산하기 위해 사용한 식 (3)과 같다.
| (3) |
각 출력 조건에 대해 동일한 구조화 입력으로 각각의 조건으로 자연어 프롬프트를 생성하였으며, 이를 30회 반복한 뒤 각 결과에 대한 IPS의 평균과 표준편차를 비교하였다. 이를 통해 출력 길이 및 표현 방식의 변화가 구조화 정보 보존에 미치는 영향을 분석하였으며, 결과는 표 10과 같다.
Comparison of IPS according to output conditions
4.4 결과 및 분석
첫 번째 실험 결과 구조화 정보가 제공된 조건에서 반복 생성 결과의 일관성이 향상되는 경향을 확인하였다. 캐릭터 정보를 제공한 Case 1에서는 베이스라인 대비 캐릭터 일관성 점수가 증가하였으며, 이는 명시적인 캐릭터 속성 정보가 반복 생성 과정에서 등장인물의 특성을 일관되게 유지하는 데 기여할 수 있음을 보여준다. 또한 분위기 정보를 추가한 Case 2에서는 분위기 일관성 점수가 증가하여 작품 전반의 정서적 특성이 보다 일관적으로 유지되는 경향을 보였다. Case 3에서는 캐릭터와 분위기 정보의 일관성을 유지하면서 추가적으로 입력된 기준 서사 곡선과 높은 유사도를 보이는 것을 확인하였다. 이는 구조화된 도메인 정보가 생성 모델의 표현을 제한하는 것이 아니라, 생성 과정에서 유지해야 하는 핵심 요소를 명확하게 제공하여 결과물의 변동성을 줄이는 데 활용될 수 있음을 시사한다. 다만 각 조건의 일관성 점수는 30개의 생성 결과를 하나의 표본 집합으로 이용하여 산출한 단일 관측값으로, 조건 간 차이에 대한 통계적 유의성 검정은 수행하지 않았으므로 관찰된 차이를 통계적으로 검증된 효과로 해석하는 데에는 한계가 있다.
두 번째 실험에서는 구조화된 입력 정보가 자연어 프롬프트 생성 과정에서 안정적으로 보존되는지를 확인하였다. 실험 결과, 출력 조건에 따른 차이는 존재하였으나 모든 조건에서 높은 수준의 정보 보존도를 나타냈으며, 출력 길이가 증가할수록 IPS 평균은 증가하고 반복 생성 결과 간 표준편차는 감소하는 경향을 보였다. 이는 구조화된 정보가 자연어 표현으로 변환되는 과정에서 생성 모델이 유지해야 하는 핵심 속성을 명확하게 전달할 수 있음을 의미한다. 또한 동일한 구조화 정보를 기반으로 다양한 형태의 자연어 프롬프트를 생성하더라도 원래의 의미 정보가 유지되는 것을 확인함으로써, 구조화 입력이 자연어 프롬프트 생성 과정에서 의미 정보의 보존을 지원할 수 있음을 확인하였다.
Ⅴ. 결론 및 향후 과제
본 연구는 자연어 기반 입력에서 발생하는 표현의 모호성과 이에 따른 생성 결과의 불확실성을 완화하기 위해 다중 보조 채널을 활용하는 구조화 지식 중개 모델을 제안하고, 단편 서사 생성 도메인을 대상으로 그 적용 가능성을 검증하였다. 기존의 프롬프트 엔지니어링 중심 접근 방식은 사용자가 요구사항을 자연어 프롬프트로 구체적으로 표현하는 능력에 의존하는 한계가 있으며, 이에 본 연구에서는 사용자의 자연어 명령을 구조화된 지식 표현과 직관적인 보조 채널을 통해 명시화하고 이를 생성 과정에 활용하는 제어 구조를 제시하였다.
특히 단편 서사 창작 도메인의 특성을 반영하여 캐릭터의 사회적 관계, 태도, 내적 동기 등 서사의 핵심 속성을 구조화하고, 이를 정량적 요소와 정성적 요소로 모델링하였다. 또한 분위기와 서사 구조를 별도의 제어 요소로 정의하여 생성 과정에서 활용함으로써 사용자가 의도한 서사적 특성이 결과물에 일관되게 반영될 수 있도록 하였다.
실험 결과, 구조화된 도메인 지식이 제공된 경우 캐릭터와 분위기에 대한 생성 결과의 일관성이 높게 나타나는 경향을 보였으며, 입력된 서사 구조에 대한 준수도 또한 높게 나타났다. 이를 통해 구조화된 도메인 정보가 서사를 구성하는 핵심 제어 요소와 사용자 지정 정보를 생성 결과에 일관되게 반영하는 데 활용될 수 있음을 확인하였다.
다만 본 논문에서 제시한 지식 중개 시스템은 단편 서사 생성이라는 특정 문제 도메인의 특성을 기반으로 설계되었다는 한계가 있다. 또한 본 연구에서는 구조화된 정보가 제공되지 않은 베이스라인과의 비교를 통해 구조화 정보 제공의 효과를 검증하였으나, 동일한 정보를 자연어로 서술하여 제공하는 방식과의 직접적인 비교는 수행하지 않았다. 향후 연구에서는 제안한 다중 보조 채널 기반 구조화 메커니즘을 다양한 산업 및 학술 도메인에 적용할 수 있도록 도메인 지식 표현 방식과 중개 구조를 확장하고, 자연어 기반 입력 방식과의 비교를 통해 구조화된 정보 제공 방식의 효과를 보다 체계적으로 검증할 필요가 있다. 또한 입력 형식과 제어 규칙을 다양한 도메인에 적용할 수 있도록 일반화된 추상화 모델을 개발할 필요가 있다.
Acknowledgments
본 논문은 2026년도 한국정보기술학회 하계종합학술대회에서 발표한 논문(AI 스토리텔링의 서사 구조 및 문체 변이 제어를 위한 동적 서사 곡선 기반 프레임워크 연구)[13]을 확장한 것임.
References
-
F. Dell'Acqua, E. McFowland III, E. Mollick, H. Lifshitz-Assaf, K. Kellogg, S. Rajendran, L. Krayer, F. Candelon, and K. R. Lakhani, "Navigating the Jagged Technological Frontier: Field Experimental Evidence of the Effects of Artificial Intelligence on Knowledge Worker Productivity and Quality", Organization Science, Vol. 37, No. 2, pp. 403-423, Mar. 2026.
[https://doi.org/10.1287/orsc.2025.21838]

-
V. Geroimenko, "The Essential Guide to Prompt Engineering", Springer, Mar. 2025.
[https://doi.org/10.1007/978-3-031-86206-9]
-
P. Bansal, "Prompt Engineering Importance and Applicability with Generative AI", Journal of Computer and Communications, Vol. 12, No. 10, pp. 14-23, Oct. 2024.
[https://doi.org/10.4236/jcc.2024.1210002]
-
G. Maziarczyk and J. K. Teske, "Narrative Form and Mentality in Contemporary Fiction", Narrative, Vol. 34, No. 1, pp. 90-124, Jan. 2026.
[https://doi.org/10.1353/nar.2026.a980960]
-
R. Barthes and L. Duisit, "An Introduction to the Structural Analysis of Narrative", New Literary History, Vol. 6, No. 2, pp. 237-272, Jan. 1975.
[https://doi.org/10.2307/468419]
- L. Golden and O. B. Hardison, Jr., Aristotle's Poetics, University Press of Florida, Feb. 1982.
-
V. Propp, Morphology of the Folktale, L. Scott, Trans., L. A. Wagner, Ed., University of Texas Press, Jan. 1968.
[https://doi.org/10.7560/783911]
- M. M. Bakhtin, "Forms of Time and of the Chronotope in the Novel: Notes toward a Historical Poetics", The Dialogic Imagination: Four Essays, M. Holquist, Ed., C. Emerson and M. Holquist, Trans., University of Texas Press, pp. 84-258, 1981.
- B.-H. Gu, "Four Steps in Composition Jeolgu [絶句] in Sino-Korean Poetry", Journal of Korean Literature, No. 30, pp. 265-292, Nov. 2014.
-
H. P. Abbott, The Cambridge Introduction to Narrative, 3rd ed., Cambridge University Press, Jan. 2021.
[https://doi.org/10.1017/9781108913928]
- J. Campbell, The Hero with a Thousand Faces, 3rd ed., New World Library, Jul. 2008.
- G. Freytag, Freytag's Technique of the Drama: An Exposition of Dramatic Composition and Art, E. J. MacEwan, Trans., Scott, Foresman and Company, 1894.
- G.-S. Lee and R. Yu, "Dynamic Narrative Curve-Based Framework for Controlling Plot Structure and Stylistic Variation in AI Storytelling", Korean Journal of Journalism & Communication, Vol. 21, No. 1, pp. 536-538, Jun. 2026.
2002년 2월 : 아주대학교 미디어학부(공학사)
2004년 2월 : 아주대학교 정보통신전문대학원 정보통신공학과(공학석사)
2013년 2월 : 아주대학교 정보통신전문대학원 정보통신공학과(공학박사)
2020년 1월 ~ 현재 : CNAI 수석연구원
관심분야 : 인공지능, 인지과학, HCI
2018년 2월 : 한양대학교 국어교육 전공(교육학박사)
2020년 9월 ~ 현재 : 국립공주대학교 교양학부 부교수
관심분야 : 국어교육, 교양교육, 대학 글쓰기, 문학