커리큘럼 기반 난이도 보정 신호 처리를 활용한 금융 시계열 트레이딩 전략의 성과 개선

초록
금융 시계열의 잡음 제거 연구는 대부분 평활화 자체에 머물러 학습 난이도 개념과 결합되지 않았고, 신호 처리를 적용한 기존 백테스트에서는 웨이블릿의 비인과성에 따른 선견 편향이 명시적으로 통제된 사례를 찾기 어렵다. 본 연구는 커리큘럼의 난이도 개념을 잡음 제거 강도의 보정 기준으로 삼고, 신호를 과거 구간에서만 생성하는 인과적 절차를 도입한다. 미국 ETF 17종(2015–2024)의 3개월 모멘텀 전략에서 기준 전략의 음(−)의 샤프지수(−0.081)는 웨이블릿 적용 후 +0.041로 전환되었다(t = 3.41, p = 0.004, Cohen's d = 0.83). 커리큘럼을 문자 그대로 구현한 점진 스케줄은 오히려 성과가 낮아, 개선의 본질이 진행 순서가 아니라 강도 보정임을 확인하였다. 다만 손익분기 거래비용이 약 1.2bp에 불과하여 본 연구는 신호 처리 방식 간 비교에 국한된다.
Abstract
Existing denoising studies on financial time series largely stop at smoothing itself without linking it to the notion of learning difficulty, and prior backtests using signal processing rarely control the look-ahead bias arising from the non-causal nature of the wavelet transform. This study addresses both gaps by using the difficulty concept of curriculum learning as the criterion for calibrating denoising strength, and by generating signals strictly from past data. On 17 US ETFs over 2015–2024 with a 3-month momentum strategy, the wavelet method turns the baseline's negative Sharpe ratio (−0.081) positive (+0.041; t = 3.41, p = 0.004, Cohen's d = 0.83, permutation p = 0.002). A literal progressive schedule underperforms the calibrated variant, indicating that the benefit stems from calibrating the denoising strength rather than from the progression order. However, high turnover leaves a breakeven transaction cost of about 1.2bp, so the findings are confined to a comparison among signal-processing methods.
Keywords:
curriculum learning, algorithmic trading, financial time series, wavelet transform, momentum strategy, signal processingⅠ. 서 론
금융 시장에서의 알고리즘 트레이딩은 지난 20여 년간 성장하였으며, 전통적인 규칙 기반 시스템에서 데이터 기반 기계학습 시스템으로의 전환이 가속화되고 있다. 특히 강화학습(Reinforcement learning)은 순차적 의사결정 문제를 다루는 데 적합한 특성으로 인해 포트폴리오 관리 및 트레이딩 분야에서 학계와 실무 모두의 관심을 받고 있다[1][2].
그러나 금융 시계열 데이터는 신호 대 잡음비(SNR, Signal-to-Noise Ratio)가 낮고, 시간에 따라 통계적 특성이 변화하는 비정상성(Non-stationarity)을 보이며, 상승장에서 하락장으로의 급격한 체제 전환(Regime switching)이 빈번하게 발생한다[3][4]. 이러한 특성들은 학습 과정을 불안정하게 만들고 과적합(Overfitting)의 주요 원인이 되어, 표본내(In-sample) 성과와 표본외(Out-of-sample) 성과 간의 괴리를 유발한다[5].
이러한 배경에서 본 연구는 인간의 교육 과정에서 착안한 커리큘럼 학습 패러다임을 금융 도메인에 적용하고자 한다. 커리큘럼 학습의 핵심 원리는 복잡한 문제를 처음부터 전체적으로 학습하는 것이 아니라, 상대적으로 용이한 예제에서 시작하여 점진적으로 난이도를 증가시키는 것이다[6]. 금융 시계열의 맥락에서 "용이한" 데이터란 잡음이 제거되어 추세와 패턴이 비교적 잘 관찰되는 데이터를 의미하며, "난해한" 데이터는 원시 데이터 그대로의 잡음이 포함된 데이터를 의미한다.
커리큘럼 학습은 Bengio et al.[6]이 기계학습 분야에 공식적으로 도입한 학습 방법론으로, 학습 데이터의 제시 순서가 모형의 최종 성능에 유의한 영향을 미친다는 관찰에 기반한다. 형식적으로, 학습 데이터가 주어지고 각 표본의 난이도를 측정하는 함수 d: X → ℝ⁺가 정의될 때, 학습 시점 t에서 사용되는 데이터의 부분집합은 난이도 임계값 λ(t)에 의해 결정되며, 이 임계값은 시간에 따라 단조 증가하여 최종적으로는 전체 데이터를 포함하게 된다[7].
본 연구의 목적은 금융 시계열의 잡음 수준을 난이도 척도로 활용하는 커리큘럼 기반 난이도 보정 신호 처리 체계를 설계하고, 이를 통해 모멘텀 기반 트레이딩 전략의 성과를 개선하는 것이다. 특히 본 연구는 세 가지 측면에 주목한다. 첫째, 신호 처리 기법(웨이블릿, 지수이동평균)에 따라 난이도 보정의 효과가 어떻게 달라지는지를 동일 조건에서 비교한다. 둘째, 커리큘럼의 난이도를 반영하는 두 방식인 ① 난이도 수준에 맞춰 강도를 보정하는 방식과 ② 진행 순서를 문자 그대로 구현하는 점진 스케줄 방식을 비교하여 성과 개선의 원천을 규명한다. 셋째, 신호 처리를 활용한 트레이딩 백테스트에서 흔히 간과되는 선견 편향 문제를 명시적으로 통제한다. 웨이블릿 변환과 같은 창 전체 기반 변환은 부주의하게 적용될 경우 미래 정보를 신호에 유입시켜 성과를 과대평가하게 만들 수 있으므로, 본 연구는 신호 생성을 과거 구간에만 의존하는 엄격한 인과적 절차로 설계하였다. 본 연구는 커리큘럼으로 학습되는 심층 강화학습 정책을 직접 훈련하지 않고, 커리큘럼의 난이도 개념을 규칙 기반 모멘텀 전략의 신호 처리에 반영한 프록시(Proxy)를 분석 대상으로 삼는다. 이는 학습 불안정성과 무작위 초기화에서 비롯되는 분산을 배제한 통제된 조건에서, 신호 처리 기법과 난이도 반영 방식이 성과에 미치는 순수 효과를 분리하여 관찰하기 위한 설계이다. 따라서 본 연구의 결과는 난이도 보정 신호 처리의 유효성에 관한 것이며, 학습되는 정책 내에서의 커리큘럼 효과는 6장에서 후속 과제로 논의한다.
본 논문의 이후 구성은 다음과 같다. 제2장에서는 선행 연구를 검토하고, 제3장에서는 연구 방법론을 기술한다. 제4장에서는 실험 설계를, 제5장에서는 실증 분석 결과를 제시하며, 제6장에서 논의, 제7장에서 결론을 제시한다.
Ⅱ. 선행 연구
2.1 금융 시계열 강화학습
강화학습을 금융 트레이딩에 적용한 연구는 Moody and Saffell[1]의 선구적 연구에서 시작되었다. 해당 연구에서는 순환 신경망과 강화학습을 결합하여 외환 및 주식 시장에서 직접적인 수익 극대화를 목표로 하는 트레이딩 시스템을 개발하였으며, 차별적 샤프지수(Differential Sharpe ratio)를 보상 함수로 도입하여 위험조정수익률의 직접 최적화를 가능하게 하였다.
이후 심층학습(Deep learning)의 발전과 함께 DQN(Deep Q-Network), Policy Gradient, Actor-Critic 등 다양한 심층 강화학습 알고리즘이 금융 분야에 적용되었다. Deng et al.[8]은 순환 신경망 기반의 심층 강화학습 모형을 제안하여 주식 시장에서의 자동 거래 시스템을 구현하였고, Jiang et al.[2]은 합성곱 신경망을 활용한 포트폴리오 관리 시스템을 개발하여 암호화폐 시장에서 검증하였다. Fischer and Krauss[9]는 LSTM 네트워크를 활용하여 S&P 500 구성 종목의 일별 방향을 예측하고, 이를 기반으로 한 트레이딩 전략이 벤치마크 대비 초과 수익을 달성할 수 있음을 제시하였다. Zhang et al.[10]은 심층 강화학습을 시계열 모멘텀 및 추세 추종 전략에 적용하고, 거래비용을 반영한 조건에서 성과를 평가하였다.
그러나 이들 연구는 금융 데이터 고유의 높은 잡음과 비정상성으로 인한 학습 불안정성 문제를 충분히 다루지 못하였으며, 학습 데이터와 검증 데이터 간의 분포 차이로 인한 일반화 실패의 위험이 지적됐다[5]. 본 연구는 이러한 문제를 커리큘럼의 난이도 개념을 신호 처리에 적용하여 완화하고자 한다.
최근에는 이 분야의 연구 동향을 정리한 조사 연구도 축적되고 있다. Sezer et al.[11]은 금융 시계열 예측에 딥러닝을 적용한 연구를 체계적으로 조사하였고, Sun et al.[12]은 정량 트레이딩에 강화학습을 적용한 연구를 과제 유형별로 정리하였다. Théate and Ernst[13]는 심층 Q-네트워크를 알고리즘 트레이딩에 적용하고 거래비용을 반영한 평가를 수행하였다. 이들 연구는 공통적으로 백테스트 설계의 엄밀성, 특히 표본외 평가와 거래비용 반영의 중요성을 강조하고 있으며, 본 연구 역시 이러한 요건을 설계에 반영하였다.
2.2 커리큘럼 학습의 발전과 응용
커리큘럼 학습은 Bengio et al.[6]의 공식화 이후 다양한 분야에서 활발히 연구되어 왔다. Kumar et al.[14]는 자기 주도 학습(Self-paced learning)이라는 변형을 제안하여 모형 스스로 학습 표본의 난이도를 평가하고 커리큘럼을 구성하도록 하였다. 이 접근법은 사전에 정의된 난이도 함수에 의존하지 않고 학습 과정에서 적응적으로 난이도를 결정할 수 있다는 장점이 있다.
강화학습 분야에서 커리큘럼 학습은 희소 보상(Sparse reward) 문제를 완화하는 데 유효한 것으로 보고되었다. Narvekar et al.[15]은 강화학습을 위한 커리큘럼 학습에 관한 포괄적인 문헌 조사를 통해 태스크 수준, 목표 수준, 초기 상태 수준의 커리큘럼 설계 방법론을 체계화하였으며, Florensa et al.[16]은 역방향 커리큘럼 생성 기법을 제안하여 목표 상태에서 시작해 점차 시작 상태를 멀리함으로써 로봇 조작 태스크에서 학습 효율을 향상시켰다.
커리큘럼 학습은 2020년 이후에도 활발히 연구되고 있다. Wang et al.[17]은 난이도 측정과 학습 일정 설계를 축으로 커리큘럼 학습 연구를 체계화하였으며, Portelas et al.[18]은 학습 과정에서 난이도를 자동으로 조절하는 자동 커리큘럼 학습의 흐름을 정리하였다. 이들 연구는 난이도의 정의와 조절 방식이 성능을 좌우하는 핵심 요소임을 공통적으로 지적한다.
금융 분야에서의 적용은 상대적으로 초기 단계이나 최근 사례가 등장하고 있다. Koh et al.[19]는 금융 시계열 제어 과제에 커리큘럼 학습과 모방 학습을 적용하고 데이터 증강을 통해 학습 과정의 잡음을 완화하는 방식을 제안하였다. 본 연구는 이러한 흐름과 문제의식을 공유하되 두 가지 점에서 구별된다. 첫째, 데이터 증강 대신 웨이블릿과 지수이동평균이라는 신호 처리 기법으로 난이도를 조작화하여 잡음 제거 기법 간 비교를 수행한다. 둘째, 진행 순서로서의 커리큘럼과 난이도 수준의 보정을 분리하여 비교함으로써 성과 개선의 원천을 규명한다. 다만 Koh et al.이 학습되는 정책을 대상으로 하였지만 본 연구는 규칙 기반 전략을 대상으로 하므로, 두 연구의 결과를 직접 비교하기는 어렵다.
2.3 금융 시계열 신호 처리
금융 시계열에서 잡음을 제거하고 신호를 추출하기 위한 다양한 신호 처리 기법이 연구되어 왔다. 가장 기본적인 방법인 이동평균은 구현이 단순하고 해석이 용이하나, 시간 영역의 단일 모수 평활화이므로 위상 지연(Phase lag)을 유발하여 실시간 트레이딩에서 신호의 적시성을 저하시키는 한계가 있다[20].
웨이블릿 변환은 1990년대부터 금융 시계열 분석에 활용되기 시작하였다. Ramsey and Zhang[21]은 외환 데이터의 다중 척도 구조를 분석하기 위해 웨이블릿 분해를 적용하였으며, 서로 다른 시간 척도에서 가격 동향이 상이한 특성을 보임을 발견하였다. Gençay et al.[22]는 웨이블릿 다중척도 분해를 통해 체계적 위험(베타)이 시간 척도에 따라 달라짐을 보였으며, 이는 금융 시계열이 척도별로 상이한 구조를 갖는다는 근거를 제공한다. 웨이블릿 변환의 주요 장점은 시간과 주파수 영역 모두에서 국소화된 분석이 가능하다는 점으로, 이는 비정상 시계열인 금융 데이터 분석에 특히 적합하다.
2.4 본 연구의 차별점
앞서 검토한 선행 연구는 세 가지 공백을 남기고 있다.
첫째, 금융 시계열의 잡음 제거 연구는 대부분 평활화 자체를 목적으로 하며, 잡음 수준을 학습 난이도로 해석하여 처리 강도를 체계적으로 조절하는 관점은 제시되지 않았다. 웨이블릿을 활용한 기존 연구[21][22]는 시계열의 다중 척도 구조를 규명하는 데 초점을 두었을 뿐, 잡음 제거 강도를 어떤 기준으로 정할 것인지에 대한 원리는 다루지 않는다. 본 연구는 커리큘럼의 진행 함수가 규정하는 난이도를 강도 결정의 기준으로 삼아 이 공백을 메운다.
둘째, 신호 처리를 적용한 기존 백테스트 연구는 웨이블릿 변환의 비인과성에서 비롯되는 선견 편향을 명시적으로 통제하지 않았다. 이산 웨이블릿 변환은 창 전체를 참조하므로 검증 구간을 포함한 창에 적용하면 미래 정보가 신호에 유입되어 성과가 과대평가된다. 본 연구는 신호 생성을 과거 구간에만 의존하는 인과적 절차로 설계하여 이 문제를 배제한다.
셋째, 커리큘럼 학습을 다룬 연구는 진행 순서의 효과와 난이도 수준 자체의 효과를 분리하여 검증하지 않았다. 금융 분야에 커리큘럼을 적용한 Koh et al.[19] 역시 학습 정책 내에서의 성능 개선을 보고할 뿐, 개선이 진행 순서에서 비롯되는지 난이도 수준의 적절성에서 비롯되는지는 구분하지 않는다. 본 연구는 두 방식을 동일 조건에서 직접 비교하여 성과 개선의 원천을 규명한다.
이러한 공백에 대응하여 본 연구는 다음을 기여한다. (i) 커리큘럼의 난이도 개념을 신호 처리 강도의 결정 기준으로 조작화하고 웨이블릿과 지수이동평균을 동일 조건에서 비교한다. (ii) 인과적 신호 생성 절차를 제시하여 선견 편향을 통제한다. (iii) 난이도 보정 방식과 점진 스케줄 방식을 비교하여, 규칙 기반 설정에서 성과를 이끄는 것이 진행 순서가 아니라 강도 보정임을 밝힌다.
Ⅲ. 연구방법
3.1 문제 정의
커리큘럼 학습은 본래 순차적 의사결정 문제의 학습을 전제하므로, 본 연구가 다루는 트레이딩 문제의 구조를 마르코프 결정 과정(MDP, Markov Decision Process)의 체계로 간략히 정식화한다[23]. 트레이딩 MDP는 5-튜플 M = (S, A, P, R, γ)로 정의되며, 상태 공간 S는 과거 수익률 시계열, 행동 공간 A = {−1, 0, +1}은 매도·관망·매수 포지션, 전이 확률 P는 외생적으로 결정되는 시장 역학, 보상 함수 R은 포지션에 따른 실현 수익률, γ는 할인 인자에 해당한다. 이 체계에서 학습의 목표는 기대 누적 보상을 극대화하는 최적 정책 π*를 도출하는 것이며, 이는 식 (1)과 같이 표현된다.
| (1) |
다만 본 연구는 정책을 학습하지 않고, 식 (1)의 정책 π를 고정된 규칙인 식 (13)으로 대체한 규칙 기반 전략을 분석 대상으로 삼는다. 따라서 위 정식화는 커리큘럼의 난이도 개념이 놓이는 맥락을 밝히기 위한 배경이며, 4장의 실험 설계에서 상태는 과거 W = 126 거래일 관측 창의 수익률, 행동은 모멘텀 신호의 부호, 보상은 다음 거래일의 실현 수익률에 각각 대응한다. 학습되는 정책 내에서의 커리큘럼 효과는 6장에서 후속 과제로 논의한다.
3.2 커리큘럼 기반 난이도 보정 체계
본 연구에서 제안하는 난이도 보정 체계의 핵심 원리는 금융 시계열의 잡음 수준을 학습 난이도로 해석하고, 신호 처리 기법을 통해 난이도 수준에 맞추어 잡음 제거 강도를 조절하는 것이다.
원시 수익률 시계열 rₜ가 주어질 때, 난이도 d ∈ [0, 1]에 따라 변환된 시계열 r̃ₜ는 식 (2)와 같이 정의된다.
| (2) |
여기서 f는 신호 처리 함수이고 θd는 난이도 d에 의해 결정되는 모수 집합이다. 난이도 d = 0일 때는 최대 수준의 평활화가 적용되어 잡음이 최소화된 "용이한" 데이터가 생성되고, d = 1일 때는 원시 데이터가 그대로 사용되어 가장 "난해한" 학습 환경이 된다.
학습 진행에 따른 난이도 조절은 진행 함수 g: [0,1] → [0,1]에 의해 결정된다. 진행 함수를 통해 학습 진행도에 따라 난이도를 조절하는 방식은 Platanios et al.[24]이 기계번역 과제에서 체계화한 바 있으며, 본 연구는 이를 금융 시계열의 잡음 수준에 적용한다. 학습 진행도 p ∈ [0, 1]가 주어질 때, 해당 시점의 난이도는 d = g(p)로 산출된다. 본 연구에서는 세 가지 진행 함수를 검토하였다.
선형 진행(Linear pacing)은 가장 단순한 형태로, 식 (3)과 같이 학습 진행도에 비례하여 난이도가 선형적으로 증가한다.
| (3) |
지수 진행(Exponential pacing)은 식 (4)와 같이 학습 초기에는 난이도가 완만하게 증가하다가 후반부에 급격히 증가하는 형태이다.
| (4) |
여기서 b는 곡률을 조절하는 매개변수로, 본 연구에서는 b = 2를 사용하였다.
계단 진행(Step pacing)은 식 (5)와 같이 난이도를 이산적인 단계로 증가시키는 방식이다.
| (5) |
여기서 n은 총 단계 수로, 본 연구에서는 n = 5를 사용하였다.
본 연구는 커리큘럼의 난이도 개념을 표본외 신호 생성에 반영하는 두 가지 방식을 정의하고 비교한다. 첫째, 난이도 보정(Calibrated) 방식은 진행 함수의 단계 평균 난이도 d̄ = (1/K)Σg(pₖ)를 하나의 대표 강도로 삼아 신호를 잡음 제거한다(선형 d̄ = 0.500, 지수 0.449, 계단 0.420). 둘째, 점진 스케줄(Progressive) 방식은 커리큘럼을 문자 그대로 구현하여, 신호 창을 K개의 시간 구간으로 나누고 각 구간을 해당 진행도의 난이도 g(pₖ)로 잡음 제거한다(오래된 구간일수록 쉬움=강한 평활화, 최근 구간일수록 어려움=원시). 두 방식 모두 3.4절의 인과적 절차로 구현되며, 5.4절에서 그 성과를 비교한다.
3.3 신호 처리 기법
지수이동평균(EMA, Exponential Moving Average)은 최근 관측치에 더 큰 가중치를 부여하는 평활화 기법으로, 시점 t에서 식 (6)의 재귀 관계로 정의된다.
| (6) |
여기서 α ∈ (0, 1]는 평활화 계수이며, 난이도 d에 따라 식 (7)과 같이 조절된다.
| (7) |
d = 0일 때 α = 0.05로 강한 평활화가, d = 1일 때 α = 1.0으로 원시 데이터가 유지된다. EMA는 시점 t의 값이 과거 관측치에만 의존하는 인과적(Causal) 필터라는 점에 유의한다.
이산 웨이블릿 변환(DWT, Discrete Wavelet Transform)은 Mallat[20]이 제시한 다중 해상도 분석에 기반하여 원시 신호를 근사 계수와 상세 계수로 분해한다. 신호 r[n]에 대한 수준 j에서의 분해는 식 (8) 및 식 (9)와 같다.
| (8) |
| (9) |
여기서 h[·]와 g[·]는 각각 저역통과 필터와 고역통과 필터이다. 잡음 제거를 위해 상세 계수에 식 (10)의 연성 임계처리(Soft thresholding)를 적용한다 [25].
| (10) |
임계값은 식 (11)과 같이 난이도에 따라 조정되는 범용 임계값을 사용한다.
| (11) |
여기서 N은 신호의 길이이고, σ는 가장 세밀한 수준의 상세 계수로부터 식 (12)와 같이 중앙 절대 편차(MAD)를 이용하여 추정된다.
| (12) |
여기서 c₀ = Φ⁻¹(0.75)이며, 정규분포 가정 하에서 c₀ ≈ 0.6745이다. 본 연구에서는 Daubechies-4(db4) 웨이블릿을 사용하였다[26]. 웨이블릿 변환은 창 전체를 참조하는 비인과적 변환이므로, 트레이딩 신호 생성에 그대로 적용하면 미래 정보가 유입될 수 있다. 이 문제는 3.4절에서 인과적 절차로 통제한다.
3.4 트레이딩 전략 및 인과적 신호 생성
본 연구에서는 시계열 모멘텀 전략을 기본 전략으로 채택하였다[27]. 모멘텀 전략은 과거 수익률의 지속성에 기반하며, 주식뿐 아니라 채권·상품·통화 등 자산군 전반에서 관찰되는 현상으로 보고되어 있어[28] 다양한 자산군을 포함하는 본 연구의 설정에 적합하다. 본 연구에서는 과거 관측 기간 L = 60 거래일(약 3개월)의 누적 수익률 부호로 포지션을 결정한다. 이는 Jegadeesh and Titman[29]이 제시한 3–12개월 모멘텀 지평과 정합적인 표준적 설정이다.
핵심적으로, 각 시점 t의 포지션은 과거 W = 126 거래일(약 6개월)의 과거 구간만을 잡음 제거하여 산출한다. 구체적으로 시점 t에서 과거 창 rₜ₋W:ₜ를 대표 난이도 d̄로 신호 처리하여 r̃를 얻고, 그 최근 L개 값의 합의 부호로 식 (13)과 같이 포지션을 결정한다.
| (13) |
이 절차는 시점 t의 신호가 t 이전 정보에만 의존하도록 보장하여 선견 편향을 원천적으로 배제한다. 웨이블릿과 같은 창 전체 변환도 과거 창에 대해서만 적용되므로 미래 정보가 유입되지 않는다. 매매는 원시 수익률에 대해 실현되며, 일별 전략 수익률은 Rₜ = sₜ₋₁ · rₜ로 산출되고, 포지션 변경 시 편도 거래비용 c를 차감한다. 기준 전략은 신호 처리를 적용하지 않은 원시 수익률로 동일한 모멘텀 신호를 산출한다.
식 (13)의 f는 3.2절에서 정의한 두 방식 중 하나로 구현된다. 즉 난이도 보정 방식에서는 대표 난이도 d̄로 창 전체를 한 번에 잡음 제거하고, 점진 스케줄 방식에서는 창을 구간별로 나누어 g(pₖ)로 잡음 제거한 뒤 결합한다. 두 방식의 성과는 5.4절에서 비교한다.
Ⅳ. 실험 설계
4.1 데이터
본 연구는 미국 시장에 상장된 17개 ETF를 분석 대상으로 선정하였다. 섹터 ETF 11종(XLB, XLC, XLE, XLF, XLI, XLK, XLP, XLRE, XLU, XLV, XLY)은 S&P 500을 GICS 11개 섹터로 완전 분할하는 SPDR 시리즈 전체로서, 특정 섹터를 취사선택하지 않아 선택 편의가 개입하지 않는다. 상품 ETF 4종은 귀금속(GLD, SLV), 에너지(USO), 농산물(DBA)의 세 하위 범주를 대표하도록 선정하였으며, 채권 ETF 2종은 금리 위험(TLT)과 신용 위험(HYG)을 각각 대표한다. 이러한 구성은 모멘텀이 자산군 전반에서 관찰되는 현상이라는 선행 연구[28]를 검증하기 위해 성격이 상이한 자산군을 포함한 것이다.
데이터 기간은 2015년 1월부터 2024년 12월까지 총 10년이며, Yahoo Finance를 통해 수정 종가 기준 일별 수익률로 수집하였다. XLC(2018년 상장)와 XLRE(2015년 하반기 상장)는 실제 상장 시점 이후의 데이터만 사용하였다. 이 기간은 2020년 팬데믹 급락과 회복, 2022년 금리 인상기, 2023–2024년 기술주 주도 상승장 등 다양한 시장 환경을 포함한다.
각 자산의 변동성 수준은 전체 기간 연율화 표준편차를 기준으로 15% 미만 저변동성, 15–30% 중변동성, 30% 이상 고변동성으로 분류하였다. 본 표본의 연율화 변동성은 8.5%에서 39.5% 사이에 분포하며 중앙값은 20.6%로, 위 경계는 이 분포를 세 구간으로 나누는 통상적인 구분에 해당한다. 이 경계가 결과를 좌우하지 않음을 확인하기 위해 경계를 12%, 25%와 18%, 35%로 조정하여 재분류한 결과, 두 조합 모두에서 각 구간의 평균 개선폭이 양(+)으로 유지되었다. 다만 상한을 40%까지 높이면 본 표본의 최대 변동성(39.5%)을 넘어 고변동성 집단이 공집합이 되므로, 상한은 표본 범위 내에서만 조정할 수 있다. 이 범위에서 변동성 구간 설정은 본 연구의 결론에 영향을 주지 않는다. 이 분류에 따라 저변동성 4종, 중변동성 12종, 고변동성 1종(USO)으로 구분되며, 고변동성 집단은 단일 자산이므로 해당 구간의 성과는 집단 평균이 아니라 개별 자산의 값으로 해석해야 한다.
한편 표본 기간이 짧은 XLC와 XLRE를 제외한 15종 기준의 강건성 검정에서도 기준 전략 −0.122, EMA −0.080, 웨이블릿 −0.001로 방법 간 순서가 유지되었으며, 웨이블릿의 개선은 Δ = +0.121(p = 0.010, Cohen's d = 0.77)로 유의하였다. 다만 이 경우 웨이블릿의 절대 샤프지수는 양(+)의 영역에 이르지 못하므로, 음에서 양으로의 전환은 17종 전체 기준의 결과임을 밝혀 둔다.
4.2 실험 설정
이동 시계열 교차검증(Walk-forward validation)을 통해 표본외 성과를 평가하였다[33]. 학습 기간 12개월(약 252 거래일), 검증 기간 3개월(약 63 거래일)로 설정하고 검증 기간만큼 창을 이동시켜, 자산별로 22개에서 35개(평균 34개)의 검증 구간이 생성되었으며, 구간 수의 차이는 자산별 상장 시점의 차이에서 비롯된다. 커리큘럼 단계 수 K는 10으로 설정하였다.
비교 대상은 기준 전략(신호 처리 미적용), EMA 기반, 웨이블릿 기반의 세 가지이며, 각 방법에 세 가지 진행 함수(선형, 지수, 계단)를 적용하였다. 모든 신호는 3.4절의 인과적 절차(과거 126일 창 잡음 제거)로 생성되어 선견 편향이 배제되었다. 시장 국면 분류를 위해 전체 ETF 등가중 평균 수익률에 대해 20일 이동 평균 수익률과 이동 변동성을 특징으로 K-평균 군집화(k=3)를 적용하고, 평균 수익률 기준으로 상승장(Bull), 하락장(Bear), 횡보장(Sideways)으로 명명하였다 [34].
주요 하이퍼파라미터의 설정 근거는 다음과 같다. 모멘텀 관측 기간 L = 60 거래일(약 3개월)은 Jegadeesh and Titman[29]이 제시한 3–12개월 모멘텀 지평의 하단에 해당하는 표준적 설정이다. 웨이블릿은 Daubechies-4를 사용하였는데, 이는 소실 모멘트 수와 필터 길이의 균형이 적절하여 짧은 창에서도 안정적으로 적용되는 웨이블릿으로[26], 금융 시계열 분석에서 널리 사용되어 왔다. 연성 임계처리와 중앙 절대 편차 기반 잡음 수준 추정은 Donoho and Johnstone[25]의 절차를 따랐다. 한편 잡음 제거 창 W = 126 거래일은 관측 기간 L의 두 배로 설정하였는데, 이는 잡음 수준 추정에 충분한 표본을 확보하면서도 창이 지나치게 길어져 과거의 이질적인 국면이 혼입되는 것을 피하기 위함이다. 커리큘럼 단계 수 K = 10은 세 진행 함수의 형태 차이가 단계별 난이도에 반영될 수 있는 수준으로 설정하였다. 이 두 값은 선행 연구에 근거한 것이 아니라 본 연구에서 설정한 것이므로, W에 대한 민감도는 5.5절의 표 4에 제시한다.
이들 설정의 타당성은 5.5절에서 민감도 분석으로 확인한다.
Ⅴ. 실증 분석 결과
5.1 주요 결과
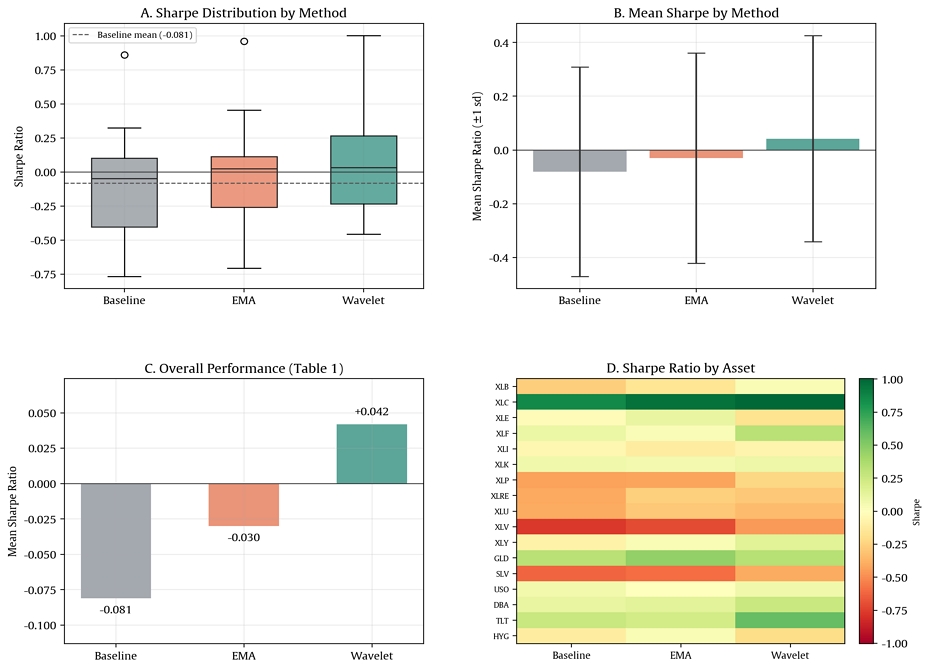
3개월 모멘텀 전략에 대한 방법론별 성과를 분석한 결과, 웨이블릿 기반 난이도 보정이 가장 높은 성과를 보였다. 주목할 점은 원시 데이터 기반 기준 전략의 평균 샤프지수가 −0.081로 음(−)의 값을 보였다는 것이다. 이는 3개월 지평의 모멘텀 신호가 일별 잡음에 크게 훼손되어, 신호 처리 없이는 표본외에서 수익을 내지 못함을 의미한다.
그림 1(a)의 자산별 샤프지수 분포에서 세 방법의 분포는 상당 부분 겹치나, 웨이블릿의 중앙값이 가장 높다. 그림 1(b)와 (c)에서 확인할 수 있듯이, EMA 기반 방법은 평균 샤프지수를 −0.030으로 개선하였으나(대응표본 t = 2.61, p = 0.019, Cohen's d = 0.63) 여전히 음(−)의 영역에 머물렀다. 반면 웨이블릿 기반 방법은 +0.041로 양(+)의 영역으로 전환되었으며, t = 3.41, p = 0.004, Cohen's d = 0.83으로 대형 효과크기에 해당하는 통계적으로 유의한 개선을 보였다. 부트스트랩 신뢰구간 역시 두 방법 모두 0을 포함하지 않아 개선의 방향성이 일관됨을 확인하였다. 그림 1(d)의 자산별 열지도에서, 방법 간 개선은 대부분의 자산에서 관찰되나 채권과 일부 섹터에서 두드러진다.
Comparison of performance by methodology
기준 전략의 음(−)의 성과를 기준으로 한 백분율 개선율은 분모가 0에 가까워 해석이 불안정하므로, 본 연구는 절대 샤프지수와 그 차이(Δ), 그리고 통계적 유의성(p, d)을 주된 근거로 제시한다. 웨이블릿의 기준 대비 절대 개선폭은 Δ = +0.122이며, 자산 단위 부트스트랩 95% 신뢰구간은 [+0.052, +0.188]로 0을 포함하지 않는다(EMA는 Δ = +0.051, [+0.014, +0.088]). 방법론별 주요 성과 지표는 표 1과 같다.

Key performance metrics by methodology
표 1의 각 항목은 다음을 나타낸다. Sharpe Ratio는 자산별 표본외 샤프지수의 평균과 표준편차이며, 표준편차가 평균보다 큰 것은 자산 간 성과 산포가 크기 때문이다. Δ는 각 방법의 샤프지수에서 기준 전략의 샤프지수를 뺀 값으로, 기준 전략의 샤프지수가 음(−)이어서 백분율 개선율이 불안정하므로 절대 차이로 제시하였다. MDD는 표본외 수익률을 연결하여 누적한 값에 대한 최대 낙폭이며 실제 포트폴리오의 낙폭과는 구분된다. p-value와 Cohen's d는 자산별 샤프지수 차이에 대한 대응표본 검정 결과이다. Buy-and-Hold는 동일 기간·동일 자산의 표본외 구간에서 항상 롱 포지션을 유지한 경우로, 방향성 타이밍을 수행하지 않아 Δ와 검정에서는 제외하였다. 매수후보유가 +0.563으로 가장 높은 것은 검증 기간이 강한 상승 국면이었던 데 기인하며, 본 연구의 결과가 수익성 있는 전략의 제시가 아니라 동일한 전략 틀 안에서의 신호 처리 방식 비교에 국한됨을 보여준다.
자산 표본이 17종으로 크지 않으므로, 정규성 가정에 의존하지 않는 검정을 추가로 수행하였다. 자산별 개선 폭의 부호를 무작위로 재배정하는 부호 순열검정(10만 회)에서 p = 0.002, 비모수 검정인 윌콕슨 부호순위검정에서 p = 0.002를 얻었다. 또한 웨이블릿 적용 후 성과가 개선된 자산은 17종 중 14종으로 이항검정 p = 0.013(양측)이었다. 세 검정 모두 대응표본 t-검정(p = 0.004)과 일관된 결론을 제시하여, 관측된 개선이 소표본에서 비롯된 우연의 산물이라고 보기는 어렵다. 다만 자산 수가 17종에 그친다는 점은 6장에서 한계로 논의한다.
5.2 자산군 및 변동성별 분석
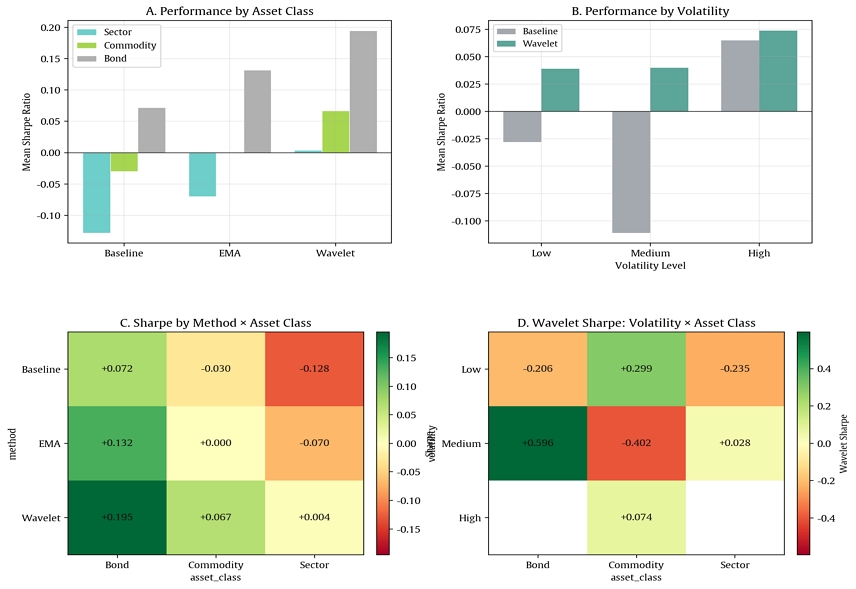
표 2는 자산군별 기준 전략, EMA, 웨이블릿의 샤프지수를 비교한 결과를 제시한다. 표 2와 그림 2(a) 및 (c)에서 보이듯이, 섹터 ETF는 기준 −0.128에서 웨이블릿 적용 후 0.004로 음(−)에서 양(+)의 경계로 전환되었고, 상품 ETF는 −0.030에서 0.067로, 채권 ETF는 0.072에서 0.188로 개선되었다. 채권 ETF가 절대 수준에서 가장 높은 샤프지수를 보였는데, 이는 채권의 추세 지속성이 강하여 모멘텀 신호의 품질이 상대적으로 높고, 잡음 제거의 효과가 명확하게 발현되기 때문으로 해석된다.
Performance by asset class
Performance analysis by asset class and volatility level
그림 2(b)의 변동성별 분석에서, 저변동성(기준 −0.028 → 웨이블릿 0.036)과 중변동성(−0.111 → 0.040) 자산에서 웨이블릿 적용 후 음(−)에서 양(+)으로의 전환이 뚜렷하게 나타났다. 반면 고변동성 자산은 기준에서 이미 양(+, 0.065)의 성과를 보였고 개선폭(→ 0.074)이 작았다. 다만 고변동성 집단은 USO 1종에 해당하므로 이 값은 집단 평균이 아니라 개별 자산의 성과이며, 이 구간에 대한 해석은 유보한다. 저·중변동성 구간의 결과는 잡음 제거를 통한 신호 품질 개선의 여지가 이 구간에서 크다는 점을 시사한다. 그림 2(d)는 자산군과 변동성의 교차 분석에서 웨이블릿 적용 후 샤프지수가 대부분의 조합에서 양(+)으로 전환됨을 보여준다.
5.3 시장 국면별 분석
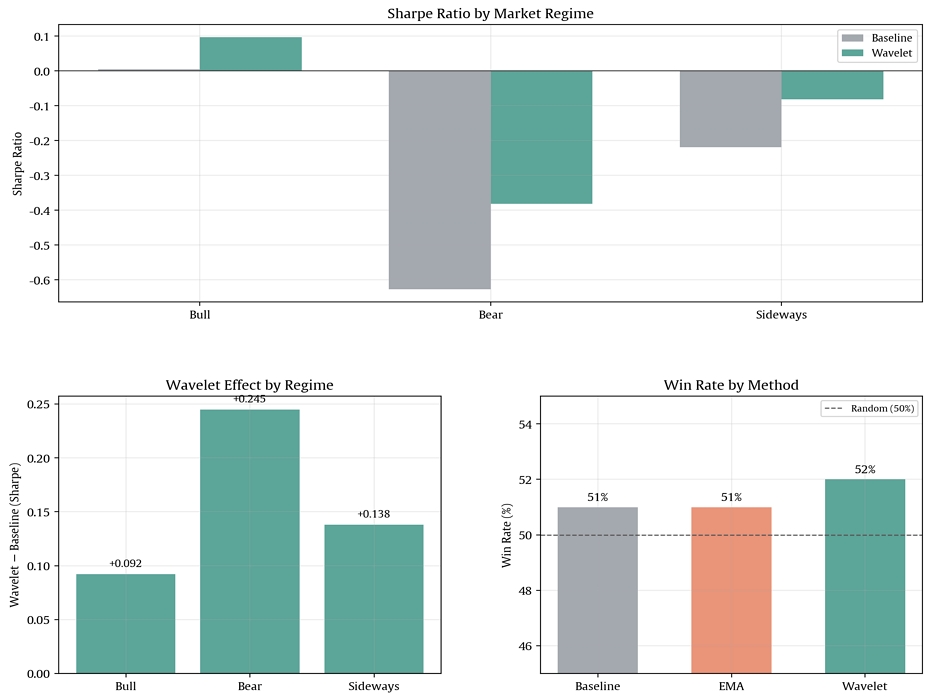
그림 3 상단에서, 상승장의 경우 기준 샤프지수가 0.005로 0에 가까웠으나 웨이블릿 적용 후 0.097로 뚜렷한 양(+)의 성과로 전환되었다. 하락장에서는 기준 −0.627에서 웨이블릿 −0.382로, 횡보장에서는 −0.219에서 −0.083으로, 손실 폭이 축소되었다. 그림 3 하단 왼쪽에서 확인할 수 있듯이 세 국면 모두에서 웨이블릿−기준의 샤프지수 차이가 양(+)으로, 잡음 제거가 국면과 무관하게 신호 품질을 개선함을 보여준다.
Performance analysis by market regime
다만 하락장과 횡보장에서는 개선에도 불구하고 절대 성과가 여전히 음(−)에 머무는데, 이는 추세가 부재하거나 반전되는 국면에서 모멘텀 전략 자체의 본질적 한계를 반영한다. 그림 3 하단 오른쪽의 승률 분석에서 웨이블릿이 52%로 가장 높았으나, 세 방법 모두 무작위 수준(50%)에 근접하여 승률만으로는 차이가 크지 않다.
5.4 난이도 반영 방식 및 진행 함수별 분석
3.2절에서 정의한 두 가지 난이도 반영 방식(난이도 보정 대 점진 스케줄)과 세 가지 진행 함수의 효과를 비교 분석하였다.
그림 4(a)는 난이도 보정 방식에서 진행 함수별 성과를 보여준다. 웨이블릿은 선형 0.041, 지수 0.026, 계단 0.018로, 대표 난이도가 0.500에서 멀어질수록(지수 0.449, 계단 0.420) 성과가 낮아졌다. 난이도 보정 방식에서 진행 함수는 대표 난이도라는 하나의 값으로 요약되므로, 이 차이는 진행 곡선의 형태가 아니라 대표 난이도 수준의 차이에서 비롯된다. EMA 역시 선형(−0.030)이 지수(−0.036) 및 계단(−0.035)보다 근소하게 높았다. 모든 진행 함수에서 웨이블릿이 EMA보다 높은 성과를 보였으며, 이는 신호 처리 기법의 선택이 진행 함수의 형태보다 성과에 더 결정적임을 시사한다.
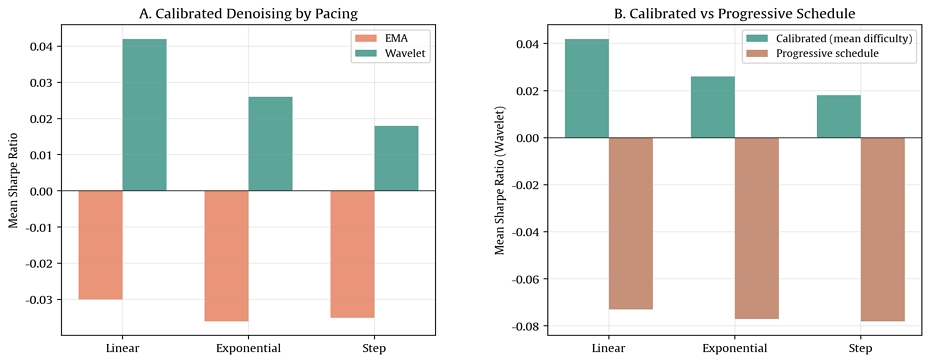
Performance analysis by difficulty scheme and pacing function
그림 4(b)는 본 연구의 중요한 발견 중 하나를 보여준다. 커리큘럼을 문자 그대로 구현한 점진 스케줄 방식은 세 진행 함수 모두에서 난이도 보정 방식보다 성과가 낮았으며, 특히 웨이블릿의 경우 보정 방식의 양(+)의 성과(선형 0.041)가 점진 스케줄에서는 음(−)으로 전환되었다(선형 −0.073, 지수 −0.077, 계단 −0.078). 이는 점진 스케줄이 커리큘럼의 원리에 따라 최근 구간을 원시(난이도 최대) 상태로 남겨 두어, 모멘텀 신호에서 가장 중요한 최근 구간의 잡음 제거 효과가 소실되기 때문이다. 요약하면, 규칙 기반 트레이딩 전략에서 성과 개선을 이끄는 것은 난이도의 진행 순서가 아니라 난이도 수준에 맞춘 잡음 제거 강도의 보정이다.
대표 난이도의 선택이 임의적이지 않음을 확인하기 위해 난이도 d를 0.1부터 0.9까지 변화시키며 웨이블릿의 성과를 산출하였다. 그 결과 평균 샤프지수는 d = 0.1에서 0.019, d = 0.3에서 0.024, d = 0.5에서 0.041, d = 0.7에서 0.021, d = 0.9에서 −0.040으로, 중간 강도에서 가장 높고 양극단에서 저하되었다. 다만 격자를 더 촘촘히 하면 응답이 단조롭지 않아, 이 값들 사이를 선형으로 보간할 수는 없다. d가 0에 가까우면 과도한 평활화로 신호 자체가 소실되고, 1에 가까우면 잡음 제거 효과가 사라지기 때문이다. 식 (3)의 선형 진행 함수에서 도출된 대표 난이도 이 이 곡선의 정점 부근에 위치한다는 점은 커리큘럼에서 유도된 난이도가 안정적인 구간에 놓여 있음을 시사한다. 다만 이는 d = 0.5가 유일한 최적값임을 의미하지는 않는다.
5.5 거래비용 민감도 및 통계적 유의성
실제 트레이딩 환경에서의 실용성을 평가하기 위해 다양한 거래비용 수준에서 성과를 분석하였다. 표 3의 모든 수치는 5.1절과 동일한 설정(관측 기간 L = 60 거래일, 잡음 제거 창 W = 126 거래일, 선형 진행 함수)에서 산출된 것이며, 거래비용 0bp 행은 표 1의 값과 일치한다.
Transaction cost sensitivity analysis
그림 5(a)의 거래비용 민감도 분석은 본 연구에서 가장 유의해야 할 결과를 보여준다. 거래비용이 없는 경우 웨이블릿(0.041)이 EMA(−0.030) 및 기준(−0.081)보다 우수하나, 거래비용이 증가하면 순위가 역전된다. 이는 웨이블릿 기반 신호가 상대적으로 회전율이 높아 거래비용에 더 민감하기 때문이다.
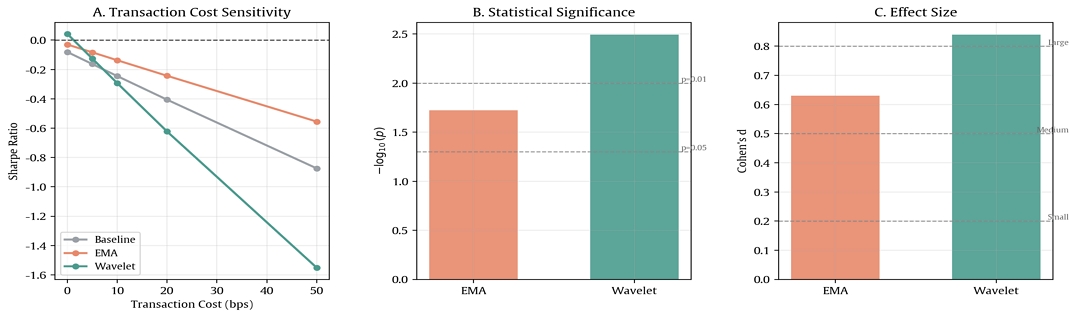
Statistical analysis and transaction cost sensitivity
실제로 방법별 연평균 회전율은 EMA 15.3회, 기준 전략 25.2회, 웨이블릿 56.2회로, 웨이블릿이 EMA의 약 3.7배에 달한다. 이 회전율 격차가 비용 구간에서의 순위 역전을 직접적으로 설명한다. 거래비용 5bp에서 웨이블릿은 −0.127로 하락하여, EMA(−0.083)보다 낮아진다. 10bp 이상에서는 웨이블릿이 기준 전략보다도 낮은 성과를 보인다. 반면 EMA는 평활화로 인한 낮은 회전율 덕분에 거래비용 전 구간에서 상대적으로 완만하게 감소한다.
표 3은 거래비용 수준에 따른 순위 역전을 보여준다. 거래비용이 없는 경우 웨이블릿(0.041)이 EMA(−0.030)와 기준 전략(−0.081)을 모두 상회하나, 5bp에서는 EMA(−0.083)가 웨이블릿(−0.127)을 앞선다. 이는 웨이블릿 신호의 연평균 회전율이 56.2회로 EMA의 15.3회보다 약 3.7배 높아 거래비용에 더 민감하기 때문이다. 웨이블릿의 손익분기 거래비용, 즉 샤프지수가 0이 되는 거래비용 수준은 약 1.2bp로 추정된다. 따라서 표 3이 시사하는 바는 신호 품질의 우위가 곧바로 실현 성과의 우위로 이어지지 않으며, 방법 선택이 거래비용 환경에 의존한다는 점이다. 또한 거래비용 5bp 이상에서는 세 방법 모두 음(−)의 샤프지수를 보이므로, 본 연구의 결과는 신호 처리 방식 간 상대적 비교에 국한되며 수익성 있는 투자 전략을 제시하는 것으로 해석되어서는 안 된다.
그림 5(b)와 (c)의 통계 분석에서, 웨이블릿의 p = 0.004로 0.01 유의수준을 충족하며, Cohen's d는 0.83으로 대형 효과 기준선(0.8)을 초과한다. EMA는 p = 0.05 수준은 충족하나(d = 0.63, 중형 효과) 웨이블릿보다 약하다. 요약하면, 거래비용을 고려하지 않은 신호 품질 자체의 관점에서는 웨이블릿이 명확히 우수하나, 거래비용을 반영한 실현 성과의 관점에서는 회전율이 낮은 EMA가 더 강건하다는 이중적 결론이 도출된다.
마지막으로 4.2절에서 설정한 관측 기간과 잡음 제거 창의 조합에 대한 민감도를 표 4에 제시한다. 네 조합 모두에서 웨이블릿이 기준 전략을 상회하여 개선의 방향성은 일관되나, 통계적 유의성은 최종 설정(L = 60, W = 126)에서만 확보되었다. 이는 본 연구의 결론이 특정 설정에 의존하는 정도를 보여주는 것으로, 보고된 p값을 해석할 때 함께 고려되어야 한다.
Sensitivity to lookback and denoising window
Ⅵ. 논 의
본 연구의 핵심 발견은 세 가지이다. 첫째, 신호 처리 기반 난이도 보정 잡음 제거가 3개월 모멘텀 전략의 표본외 성과를 유의미하게 개선하며, 이 효과는 웨이블릿에서 가장 크다는 것이다. 원시 데이터 기준 전략이 음(−)의 샤프지수(−0.081)를 보인 반면 웨이블릿 적용 후 양(+, 0.041)으로 전환된 것은, 장기 지평 모멘텀 신호가 일별 잡음에 훼손되기 쉬우며 적절한 잡음 제거가 이를 복원할 수 있음을 보여준다. 웨이블릿이 EMA보다 우수한 이유는 두 방법의 작동 기제 차이에 있다. EMA는 시간 영역의 단일 모수 평활화로 고주파 성분을 상대적으로 더 감쇠시키면서 위상 지연을 유발하는 반면, 웨이블릿은 다중 해상도 분석을 통해 척도별로 신호와 잡음을 구분하여 처리할 수 있다[20][35]. 금융 시계열에서 추세는 저주파에, 일간 잡음은 고주파에 집중되므로[20] 웨이블릿의 주파수 선택적 잡음 제거가 유리하게 작용한다.
둘째, 이러한 신호 품질의 우위가 곧바로 실현 수익의 우위로 이어지지는 않는다. 웨이블릿 신호는 회전율이 높아 거래비용에 민감하며, 거래비용 5bp 수준에서는 회전율이 낮은 EMA가 더 높은 성과를 보였다. 기관 투자자의 거래비용이 개인 투자자 대비 현저히 낮다는 점을 고려하면 [36], 웨이블릿의 이점은 극히 낮은 비용 환경에 국한된다. 손익분기 거래비용이 약 1.2bp에 불과하므로 이 이점은 사실상 거래비용이 거의 없는 이상적 환경에서만 성립하며, 거래비용이 이보다 높은 환경에서는 완전히 소멸한다. 아울러 동일 기간의 매수후보유가 +0.563의 샤프지수를 기록한 점을 고려하면, 본 연구의 어떤 방법도 단순 보유 전략을 대체할 수 있는 수준에는 이르지 못한다.
방법론적 측면에서 본 연구는 신호 처리 기반 백테스트의 선견 편향 문제를 명시적으로 통제하였다는 점에서 의의가 있다. 웨이블릿과 같은 창 전체 변환을 검증 구간에 부주의하게 적용하면 미래 정보가 신호에 유입되어 성과가 크게 과대평가될 수 있다. 본 연구는 신호 생성을 과거 구간에만 의존하는 인과적 절차로 설계함으로써 이러한 편향을 배제하였으며, 이는 신호 처리를 활용하는 후속 연구가 준수해야 할 최소 요건이다.
셋째 발견으로, 커리큘럼의 난이도를 반영하는 두 방식의 비교(5.4절)는 성과 개선의 원천에 대한 통찰을 제공한다. 커리큘럼 학습의 핵심 주장은 쉬운 예제에서 어려운 예제로의 진행 순서가 학습에 유익하다는 것이다. 그러나 본 연구의 규칙 기반 설정에서는 이 진행 순서를 문자 그대로 구현한 점진 스케줄이 오히려 성과를 저하시켰고, 난이도 수준에 맞춘 잡음 제거 강도의 보정만이 성과를 개선하였다. 이는 커리큘럼의 순서 효과가 본질적으로 학습되는 모형의 표현 학습에 기대는 반면, 학습이 부재한 규칙 기반 신호 처리에서는 진행 순서 자체가 이점을 제공하지 못함을 시사한다. 따라서 본 연구가 지지하는 것은 "커리큘럼에서 착안한 난이도 보정 신호 처리가 유효하다"는 명제이며, "진행 순서로서의 커리큘럼이 트레이딩 성과를 개선한다"는 명제는 규칙 기반 설정에서는 지지되지 않았다.
본 연구의 한계점은 다음과 같다. 첫째, 분석 대상이 ETF 17종에 국한되어 개별 주식이나 암호화폐로의 일반화는 추가 검증이 필요하다. 특히 음(−)에서 양(+)으로의 전환은 표본 기간이 짧은 두 자산에 상당 부분 의존한다. 이들을 제외한 15종 기준에서는 웨이블릿의 평균 샤프지수가 −0.001로 양(+)의 영역에 이르지 못하며, 개선의 통계적 유의성(p = 0.010)은 유지되나 절대 수준의 전환은 표본 구성에 민감하다. 따라서 본 연구가 지지하는 것은 방법 간 상대적 개선이며, 전환 자체를 일반적 결과로 해석해서는 안 된다. 둘째, 시계열 모멘텀 단일 전략만을 검증하였으며, 평균회귀 등 다른 전략에서의 효과는 확인되지 않았다. 셋째, 거래비용을 고정 비율로 단순화하여 시장 충격과 슬리피지(Slippage)의 시간 변동을 반영하지 못하였다. 실제 시장 충격은 거래 규모에 따라 비선형적으로 증가하므로[37], 대규모 자금 운용 시에는 본 연구의 추정보다 성과가 더 저하될 수 있다. 아울러 최종 설정(L = 60, W = 126)은 표 4의 네 조합을 포함한 탐색을 거쳐 선택되었으므로, 보고된 p값은 탐색 범위를 고려하면 상한으로 해석되어야 한다. 향후 연구에서는 Deflated Sharpe Ratio 등 다중 검정을 보정하는 지표의 적용이 필요하다. 또한 본 연구는 각 자산을 독립적으로 처리하여 자산 간 상호의존 구조를 신호에 반영하지 않았으므로, 자산 간 통계적 상호의존성을 그래프로 표현하여 예측 성능을 개선한 최근 접근[38]과의 결합이 확장 방향이 될 수 있다. 아울러 본 연구는 CAPM이나 Carhart 4팩터 모형 [39] 등에 기반한 팩터 조정 알파를 분석하지 않았으며, 자산 수 확대를 통한 검정력 보강과 함께 후속 과제로 남는다.
넷째, 그리고 가장 근본적으로, 본 연구는 3.4절에서 밝힌 바와 같이 커리큘럼 학습을 규칙 기반 모멘텀 프록시로 조작화하여 검증한 것으로, 커리큘럼으로 실제 학습·훈련되는 심층 강화학습 정책과는 구분된다. 따라서 본 연구의 결과는 "신호 처리 기반 난이도 조절이 규칙 기반 트레이딩 신호의 품질을 개선한다"는 명제를 지지하는 것이지, "커리큘럼 학습이 강화학습 트레이딩 에이전트의 성능을 개선한다"는 더 강한 명제를 직접 입증하는 것은 아니다. 후자의 검증에는 커리큘럼 스케줄을 학습 과정에 통합한 강화학습 파이프라인이 필요하며, 이는 본 연구의 프록시 결과를 바탕으로 한 후속 과제로 남는다.
Ⅶ. 결 론
본 연구는 커리큘럼의 난이도 개념을 금융 시계열 트레이딩에 적용하여, 난이도 수준에 맞춘 잡음 제거 강도의 보정이 3개월 모멘텀 전략의 표본외 성과를 개선할 수 있음을 실증적으로 검증하였다. 미국 ETF 17종의 10년 실측 데이터에 대한 이동 시계열 교차검증에서, 원시 데이터 기준 전략은 평균 샤프지수 −0.081로 음(−)의 성과를 보인 반면, 웨이블릿 기반 난이도 보정 방법은 +0.041로 전환되었으며 이는 대응표본 t = 3.41, p = 0.004, Cohen's d = 0.83의 통계적으로 유의한 대형 효과에 해당한다. 개선 효과는 모든 자산군, 변동성 수준, 시장 국면에서 일관되게 관찰되었다.
본 연구의 기여는 다음과 같다. 첫째, 커리큘럼 학습의 난이도 개념에서 착안한 난이도 보정 신호 처리 방식을 제시하고, 웨이블릿의 주파수 선택적 잡음 제거가 EMA의 시간 영역 평활화보다 유리함을 실증하였다. 둘째, 신호 처리 백테스트의 선견 편향을 인과적 신호 생성 절차로 통제하는 방법론을 제시하였다. 셋째, 난이도 보정 방식과 점진 스케줄 방식을 직접 비교하여, 규칙 기반 설정에서 성과 개선을 이끄는 것은 진행 순서가 아니라 난이도 수준에 맞춘 잡음 제거 강도의 보정임을 밝혔다. 넷째, 신호 품질의 우위와 거래비용 반영 실현 성과의 우위가 상이할 수 있음을 보여, 방법 선택이 거래비용 환경에 의존함을 밝혔다.
실무적 관점에서, 웨이블릿 기반 방법의 우위는 거래비용이 거의 없는 환경에 국한되며, 손익분기 거래비용이 약 1.2bp에 불과하여 5bp 수준에서는 이미 회전율이 낮은 EMA가 더 강건하다. 나아가 동일 기간의 매수후보유가 +0.563의 샤프지수를 기록한 점을 고려하면, 본 연구의 결과는 수익성 있는 전략의 제시가 아니라 신호 처리 방식이 신호 품질에 미치는 영향의 비교로 이해되어야 한다. 향후 연구에서는 개별 주식 및 암호화폐로의 자산 확장, 평균회귀 등 다른 전략에서의 검증, 거래비용을 고려한 회전율 제어, 그리고 심층 강화학습 정책과의 통합을 통해 본 연구를 확장할 필요가 있다.
References
-
J. Moody and M. Saffell, "Learning to Trade via Direct Reinforcement", IEEE Transactions on Neural Networks, Vol. 12, No. 4, pp. 875-889, Jul. 2001.
[https://doi.org/10.1109/72.935097]

-
Z. Jiang, D. Xu, and J. Liang, "A Deep Reinforcement Learning Framework for the Financial Portfolio Management Problem", arXiv preprint, arXiv:1706.10059, , Jun. 2017.
[https://doi.org/10.48550/arXiv.1706.10059]
-
J. D. Hamilton, "A New Approach to the Economic Analysis of Nonstationary Time Series and the Business Cycle", Econometrica, Vol. 57, No. 2, pp. 357-384, Mar. 1989.
[https://doi.org/10.2307/1912559]
-
A. Ang and A. Timmermann, "Regime Changes and Financial Markets", Annual Review of Financial Economics, Vol. 4, No. 1, pp. 313-337, Oct. 2012.
[https://doi.org/10.1146/annurev-financial-110311-101808]
-
M. L. de Prado, "Advances in Financial Machine Learning", John Wiley & Sons, Jan. 2018.
[https://doi.org/10.2139/ssrn.3270329]
-
Y. Bengio, J. Louradour, R. Collobert, and J. Weston, "Curriculum Learning", Proc. of the 26th International Conference on Machine Learning, Montreal, Quebec, Canada, pp. 41-48, Jun. 2009.
[https://doi.org/10.1145/1553374.1553380]
-
P. Soviany, R. T. Ionescu, P. Rota, and N. Sebe, "Curriculum Learning: A Survey", International Journal of Computer Vision, Vol. 130, No. 6, pp. 1526-1565, Jun. 2022.
[https://doi.org/10.1007/s11263-022-01611-x]
-
Y. Deng, F. Bao, Y. Kong, Z. Ren, and Q. Dai, "Deep Direct Reinforcement Learning for Financial Signal Representation and Trading", IEEE Transactions on Neural Networks and Learning Systems, Vol. 28, No. 3, pp. 653-664, Mar. 2017.
[https://doi.org/10.1109/TNNLS.2016.2522401]
-
T. Fischer and C. Krauss, "Deep Learning with Long Short-term Memory Networks for Financial Market Predictions", European Journal of Operational Research, Vol. 270, No. 2, pp. 654-669, Oct. 2018.
[https://doi.org/10.1016/j.ejor.2017.11.054]
-
Z. Zhang, S. Zohren, and S. Roberts, "Deep Reinforcement Learning for Trading", The Journal of Financial Data Science, Vol. 2, No. 2, pp. 25-40, Apr. 2020.
[https://doi.org/10.3905/jfds.2020.1.030]
-
O. B. Sezer, M. U. Gudelek, and A. M. Ozbayoglu, "Financial Time Series Forecasting with Deep Learning: A Systematic Literature Review: 2005-2019", Applied Soft Computing, Vol. 90, pp. 106181, May 2020.
[https://doi.org/10.1016/j.asoc.2020.106181]
-
S. Sun, R. Wang, and B. An, "Reinforcement Learning for Quantitative Trading", ACM Transactions on Intelligent Systems and Technology, Vol. 14, No. 3, pp. 1-29, Jun. 2023.
[https://doi.org/10.1145/3582560]
-
T. Théate and D. Ernst, "An Application of Deep Reinforcement Learning to Algorithmic Trading", Expert Systems with Applications, Vol. 173, pp. 114632, Jul. 2021.
[https://doi.org/10.1016/j.eswa.2021.114632]
- M. P. Kumar, B. Packer, and D. Koller, "Self-paced Learning for Latent Variable Models", Advances in Neural Information Processing Systems, Vol. 23, pp. 1189-1197, Dec. 2010.
- S. Narvekar, B. Peng, M. Leonetti, J. Sinapov, M. E. Taylor, and P. Stone, "Curriculum Learning for Reinforcement Learning Domains: A Framework and Survey", Journal of Machine Learning Research, Vol. 21, No. 181, pp. 1-50, Sep. 2020.
- C. Florensa, D. Held, M. Wulfmeier, M. Zhang, and P. Abbeel, "Reverse Curriculum Generation for Reinforcement Learning", Proc. of the 1st Conference on Robot Learning, Mountain View, California, USA, pp. 482-495, Nov. 2017.
-
X. Wang, Y. Chen, and W. Zhu, "A Survey on Curriculum Learning", IEEE Transactions on Pattern Analysis and Machine Intelligence, Vol. 44, No. 9, pp. 4555-4576, Sep. 2022.
[https://doi.org/10.1109/TPAMI.2021.3069908]
-
R. Portelas, C. Colas, L. Weng, K. Hofmann, and P.-Y. Oudeyer, "Automatic Curriculum Learning for Deep RL: A Short Survey", Proc. of the 29th International Joint Conference on Artificial Intelligence, Yokohama, Japan, pp. 4819-4825, Jul. 2020.
[https://doi.org/10.24963/ijcai.2020/671]
-
W. Koh, I. Choi, Y. Jang, G. Kang, and W. C. Kim, "Curriculum Learning and Imitation Learning for Model-free Control on Financial Time-series", arXiv preprint, arXiv:2311.13326, , Nov. 2023.
[https://doi.org/10.48550/arXiv.2311.13326]
-
S. G. Mallat, "A Theory for Multiresolution Signal Decomposition: The Wavelet Representation", IEEE Transactions on Pattern Analysis and Machine Intelligence, Vol. 11, No. 7, pp. 674-693, Jul. 1989.
[https://doi.org/10.1109/34.192463]
-
J. B. Ramsey and Z. Zhang, "The Analysis of Foreign Exchange Data Using Waveform Dictionaries", Journal of Empirical Finance, Vol. 4, No. 4, pp. 341-372, Dec. 1997.
[https://doi.org/10.1016/S0927-5398(96)00013-8]
-
R. Gençay, F. Selçuk, and B. Whitcher, "Multiscale Systematic Risk", Journal of International Money and Finance, Vol. 24, No. 1, pp. 55-70, Feb. 2005.
[https://doi.org/10.1016/j.jimonfin.2004.10.003]
- R. S. Sutton and A. G. Barto, "Reinforcement Learning: An Introduction", 2nd ed., MIT Press, Nov. 2018.
-
E. A. Platanios, O. Stretcu, G. Neubig, B. Poczos, and T. M. Mitchell, "Competence-based Curriculum Learning for Neural Machine Translation", Proc. of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics, Minneapolis, Minnesota, pp. 1162-1172, Jun. 2019.
[https://doi.org/10.18653/v1/N19-1119]
-
D. L. Donoho and I. M. Johnstone, "Ideal Spatial Adaptation by Wavelet Shrinkage", Biometrika, Vol. 81, No. 3, pp. 425-455, Sep. 1994.
[https://doi.org/10.1093/biomet/81.3.425]
-
I. Daubechies, "Ten Lectures on Wavelets", SIAM, Jan. 1992.
[https://doi.org/10.1137/1.9781611970104]
-
T. J. Moskowitz, Y. H. Ooi, and L. H. Pedersen, "Time Series Momentum", Journal of Financial Economics, Vol. 104, No. 2, pp. 228-250, May 2012.
[https://doi.org/10.1016/j.jfineco.2011.11.003]
-
C. S. Asness, T. J. Moskowitz, and L. H. Pedersen, "Value and Momentum Everywhere", The Journal of Finance, Vol. 68, No. 3, pp. 929-985, Jun. 2013.
[https://doi.org/10.1111/jofi.12021]
-
N. Jegadeesh and S. Titman, "Returns to Buying Winners and Selling Losers: Implications for Stock Market Efficiency", The Journal of Finance, Vol. 48, No. 1, pp. 65-91, Mar. 1993.
[https://doi.org/10.1111/j.1540-6261.1993.tb04702.x]
-
W. F. Sharpe, "The Sharpe Ratio", The Journal of Portfolio Management, Vol. 21, No. 1, pp. 49-58, Oct. 1994.
[https://doi.org/10.3905/jpm.1994.409501]
- J. Cohen, "Statistical Power Analysis for the Behavioral Sciences", 2nd ed., Lawrence Erlbaum Associates, Jul. 1988.
-
B. Efron and R. J. Tibshirani, "An Introduction to the Bootstrap", Chapman and Hall/CRC, pp. 1-397, May 1994.
[https://doi.org/10.1201/9780429246593]
-
L. J. Tashman, "Out-of-sample Tests of Forecasting Accuracy: An Analysis and Review", International Journal of Forecasting, Vol. 16, No. 4, pp. 437-450, Oct. 2000.
[https://doi.org/10.1016/S0169-2070(00)00065-0]
- J. MacQueen, "Some Methods for Classification and Analysis of Multivariate Observations", Proc. of the Fifth Berkeley Symposium on Mathematical Statistics and Probability, Vol. 1, pp. 281-297, Jun. 1967.
-
D. L. Donoho, "De-noising by Soft-thresholding", IEEE Transactions on Information Theory, Vol. 41, No. 3, pp. 613-627, May 1995.
[https://doi.org/10.1109/18.382009]
-
J. J. Angel, L. E. Harris, and C. S. Spatt, "Equity Trading in the 21st Century: An Update", Quarterly Journal of Finance, Vol. 5, No. 1, pp. 1550002, Mar. 2015.
[https://doi.org/10.1142/s2010139215500020]
- R. Almgren, C. Thum, E. Hauptmann, and H. Li, "Direct Estimation of Equity Market Impact", Risk, Vol. 18, No. 7, pp. 58-62, Jul. 2005.
-
I. Choi, W. Koh, G. Kang, Y. Jang, and W. C. Kim, "A Taxonomy of Heterogeneous Statistical Interdependencies for Graph-based Financial Time Series Prediction", Engineering Applications of Artificial Intelligence, Vol. 182, pp. 115832, Oct. 2026.
[https://doi.org/10.1016/j.engappai.2026.115832]
-
M. M. Carhart, "On Persistence in Mutual Fund Performance", The Journal of Finance, Vol. 52, No. 1, pp. 57-82, Mar. 1997.
[https://doi.org/10.1111/j.1540-6261.1997.tb03808.x]
2025년 2월 : 한국과학기술원 산업및시스템공학과(공학박사)
2026년 3월 ~ 현재 : 가천대학교 금융·빅데이터학부 조교수
관심분야 : 금융데이터사이언스, 비즈니스 인텔리전스, 데이터 기반 의사결정